Semantic Segmentation, U-Net Day 1
이미지에서 특정 패턴을 추출해보자.
들어가면서.
연구관련 논문을 읽다보면 항상 막히는 주제가 하나 있다.
건축 도면과 같은 자료에는 치수선, 문, 창문이나 기타 다른 정보들도 수두룩하게 들어있다. 여기서 내가 원하는 것만 뽑아내고 싶은데 결국 그걸 하려면 머신러닝, 딥러닝의 힘을 빌려올 수 밖에 없다.
관련하여 조사해본 논문들 중에서 UNet 계열의 알고리즘을 사용하는데, UNet이 가지는 특성을 잘 활용해 접근했다는 점에서 눈여겨볼만 했다.
그래서 이번엔 UNet에 대해 빠르게 공부해보고, 실습을 통해 따라잡아 보려 한다.
학습의 목차는 다음과 같이 하려 한다.
| Day | 핵심 주제 | 결과물 |
|---|---|---|
| 1일차 | CNN, Segmentation, U-Net 구조 | U-Net 구조 이해 + 직접 구현 |
| 2일차 | Dataset, Loss, Training | 간단한 Segmentation 모델 학습 |
| 3일차 | 건축도면 적용 | Wall/Door/Window Multi-class Segmentation |
| 4일차 | 대형 도면 + 후처리 + 정보 추출 | 도면 → Mask → Geometry → 정보 추출 Pipeline |
위의 순서대로, 이제 Day1을 진행해보자.
1. Sementic Segmantation
Deep learning과 CNN을 배우면 제일 먼저 수행해보는게 이미지 분류의 문제다. 숫자를 분류하는 것에서부터, 사람/고양이/개/쿠키(?)를 구분하는 문제에 까지 실습을 곁들여가며 해보면, 아… 모르겠다 라는 반응이 절로 나온다. 네트워크 구조는 알아도 그 안의 파라미터가 어떻게 되는지는 그날 컴퓨터 컨디션에 달린 문제인지라 좋은 전기 먹여주고 잘 어르고 달래줘야한다.(아니다. 틀려! 그럴리가)
이런 이미지 분류문제는 이미지 전체에 label을 붙인다. 즉 개 이미지인지 신발 이미지인지 하는 이미지 단위로 구분해내는 것을 목표로 한다는 것이다.
그러나 Sementic Segmentation은 이미지 안에서의 사물을 구분해내는 것을 목표로 한다. 그러면 이미지 안에서의 어떤 사물인지에 대한 벡터값과 bounding box, 그리고 좌표값을 얻을 수 있다. 가장 대표적인 알고리즘이 YOLO다.
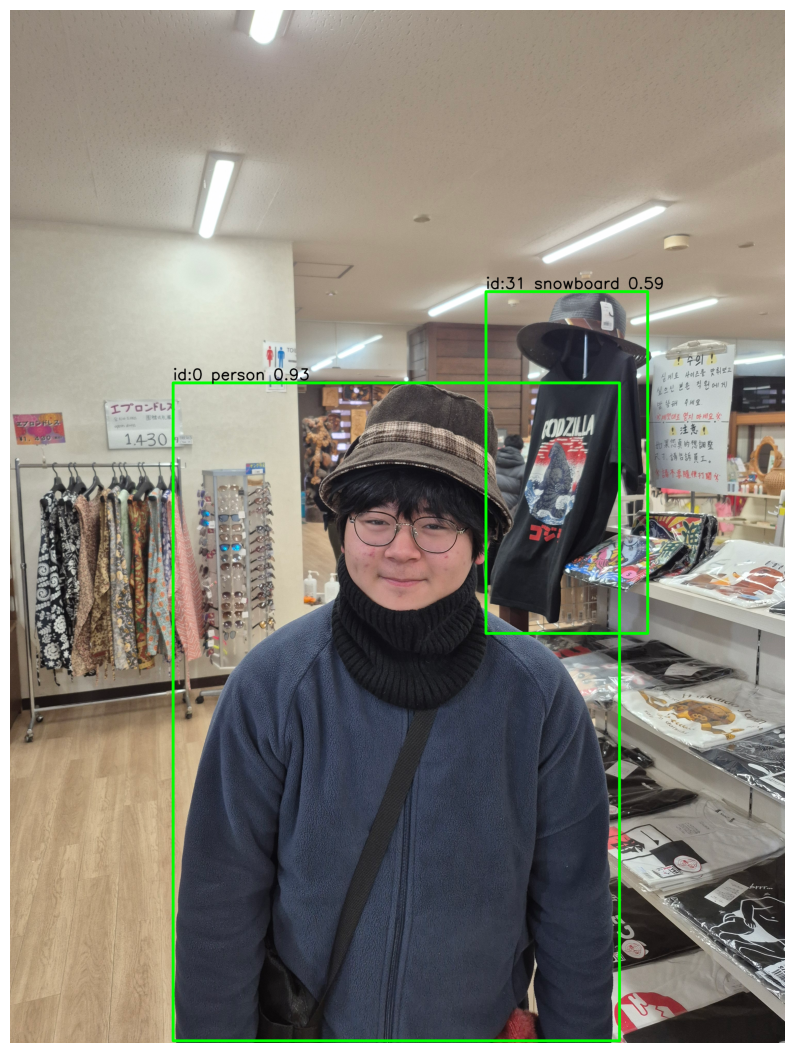
여기서 좀 더 심화되면 이미지를 픽셀단위로 구분(classfication)하기 시작한다. 이걸 수식으로 표현해보면, 가령 640X480 의 이미지가 들어간다고 해보자.
- 640 X 480 의 RGB이미지가 있다면
- 입력 : 640 X 480 X 3
- 네트워크를 통과 한 다음
- 출력 : 640 X 480 X C
로 표현할 수 있다. 여기서 C는 YOLO와 마찬가지로 구분할 수 있는 Class 개수가 된다. 이걸 건축 도면에 적용시켜보면 벽/문/창문이라 가정한다면 여기에 구분 안된 것 까지 포함해서 C=4라 할 수 있겠다.
근데 Yolo만 가지곤 안되는건가?
2. 왜 CNN은 안되나?
사실 YOLO도 최근 들어선 Segmentation이 가능해졌다. 하지만 오리지널만 따지고 본다면, 기본적으로 CNN 방식에서는 네트워크를 통과하면서 점점 크기가 줄어들기 때문에 픽셀단위의 추정이 어렵다는 문제가 있다.
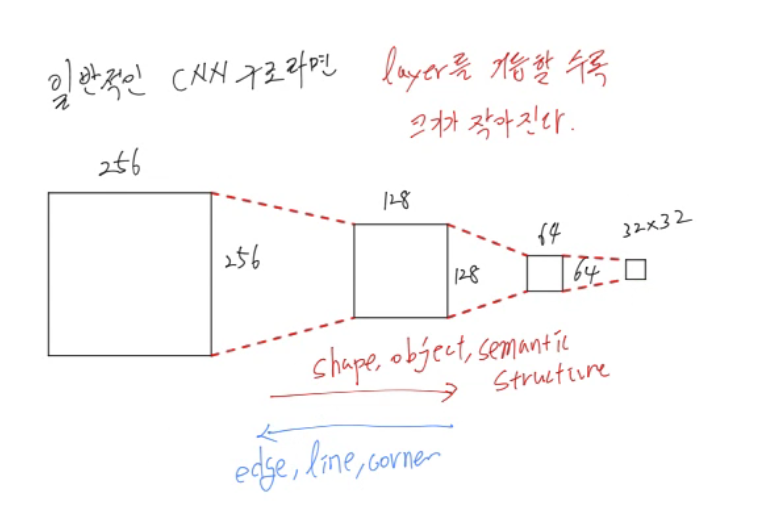
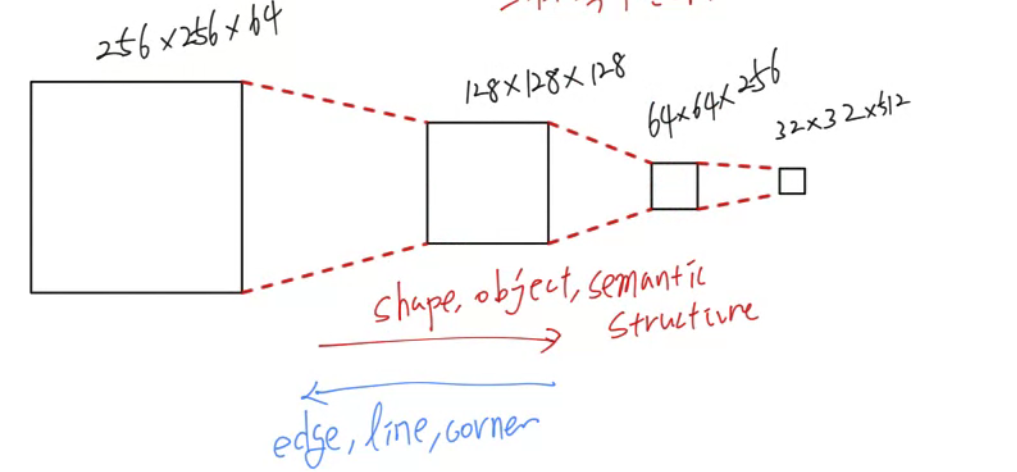
초기 layer에서는 edge/line/corner들의 특징을 가지고 있다면, 점점 layer가 깊어지면서, shape, object, sementic stucture처럼 추상적인 정보만 담게 된다. 따라서 개, 고양이를 구분할땐 layer가 깊어지게 될 수 밖에 없다.
하지만 만약 line이나 edge정보를 추출하고 싶다면 CNN의 케이스에선 다시 이걸 640크기로 확대시키는 작업을 해줘야 한다. 그래서 Encoder-Decoder 개념이 나오게 된다.
이러한 계열에서 유명한건 AutoEncoder나 GAN같은 것들이 비슷한 형태를 취하고 있지만, 이 중 pixel단위로 무언가를 구분해내는데는 U-Net이 가장 고전적이면서도 지금도 유용한 방법이다.
3. U-Net
U-Net은 의료 영상정보에서 특정정보를 분할/추출/구분하기 위해 제안된 U자 형태의 대칭형 인코더-디코더 구조를 가진 CNN이다. 논문원본
아래 그림처럼 형태의 U자형 구조를 가지고 있고, Encoder에서 Decoder로 넘어가는 부분에 Bottleneck이 있으며, Bottlenec 외에 Encoder와 Decoder를 이어주는 Skip connection을 가지고 있다.
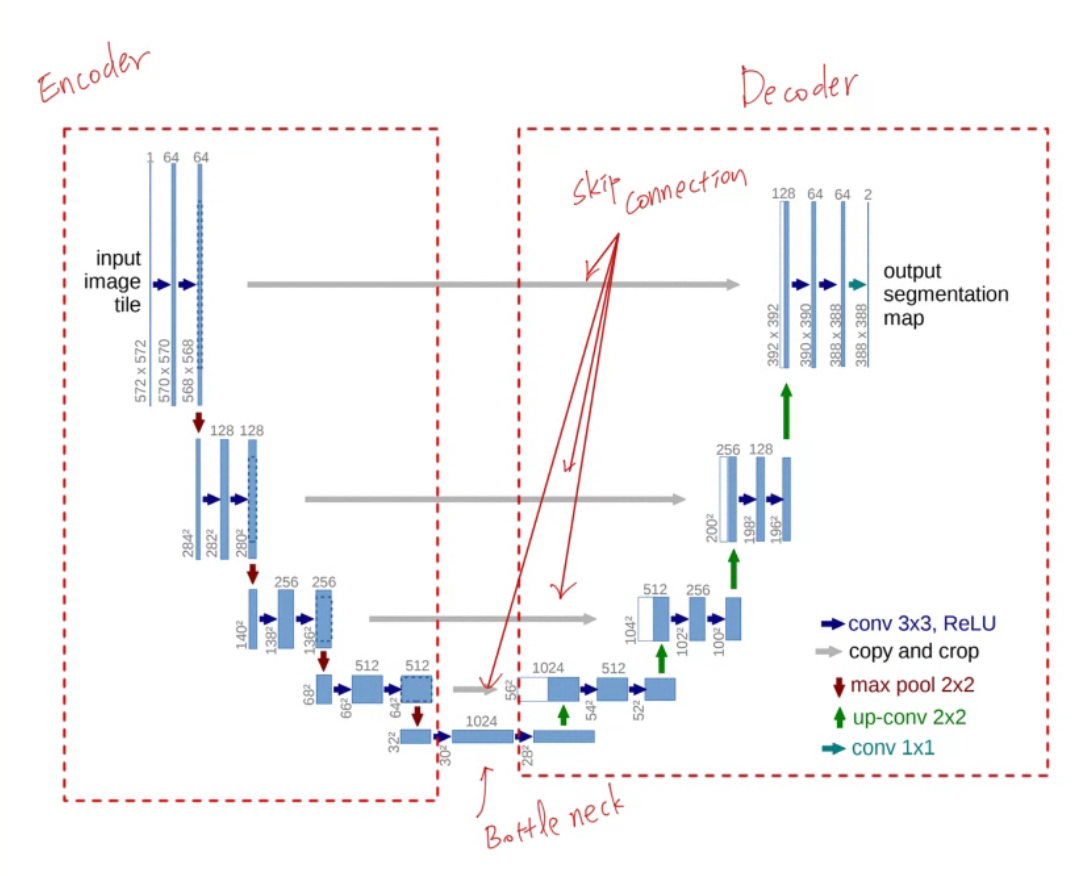
각각의 역할을 개념만 간단히 설명한다면 이렇다.
- Encoder : 무엇이 있는가? feature extraction
- Bottleneck : 가장 압축된 특징표현
- Decoder : 어디에 있는가? spatial reconstruction
- Skip Connection : Encoder의 세밀한 위치정보를 전달
그래서 이 네트워크는 논문의 이미지를 빌려 표현해보자면 목표하고자 하는 feature를 pixel단위로 추출해내는 것을 목적으로 한다.
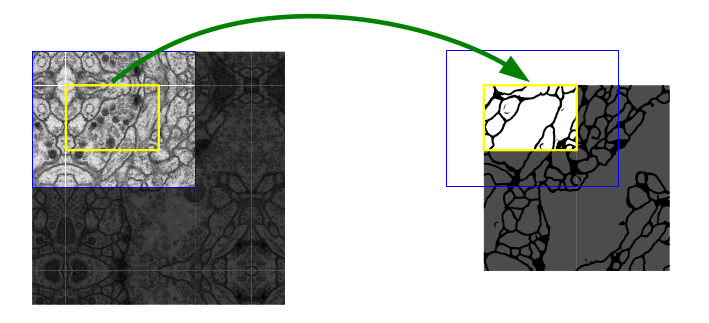
이제 이 개념을 가지고 본격적으로 각각의 모듈에 대해 파헤쳐보자.
다른 설명은 아래 링크도 참조해볼만 하다. 내가 쓰는건 공부하면서 쓰는 필기노트이고, 여기 링크는 좀더 전문적이다. 참고링크
ps. 참고링크에선 추가로 Semenctic Segmentation과 Instance Segmentation의 개념과, U-Net이 Diffusion으로 발전한 내용을 언급한다. 참고해볼만 한 질문이다.
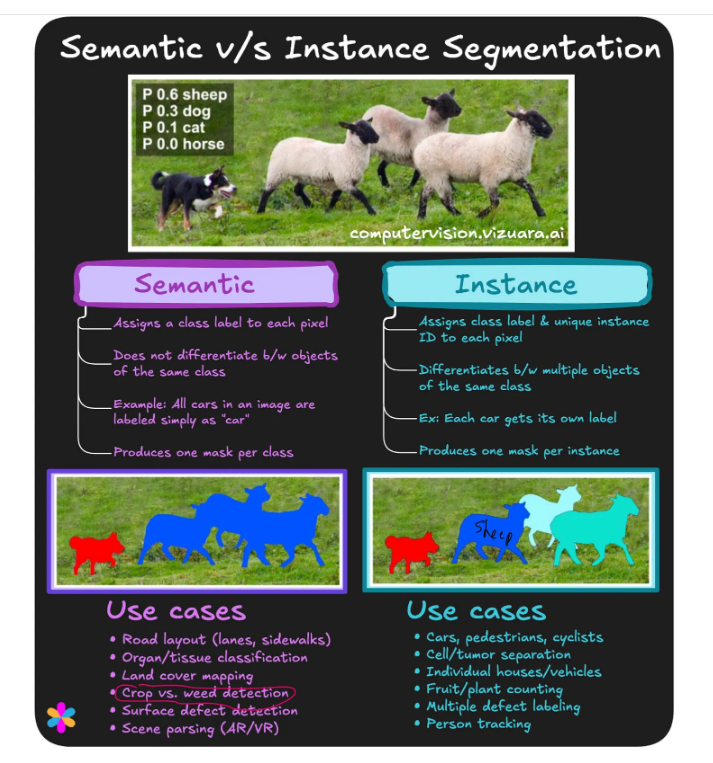
Encoder
Encoder는 여느 CNN과 마찬가지로 Conv-ReLU-Conv-ReLU-Pooling 을 반복한다. input이 256x256x3 이라면, 공간의 해상도는 256 → 128 → 64 → 32 방식으로 감소하겠지만, channel 의 숫자는 64 → 128 → 256 → 512으로 증가한다. 이는 이미지의 위치 정보는 압축하면서 특징 표현은 풍부하게 만든다고 생각하면 이해하기 좋다.
Decoder
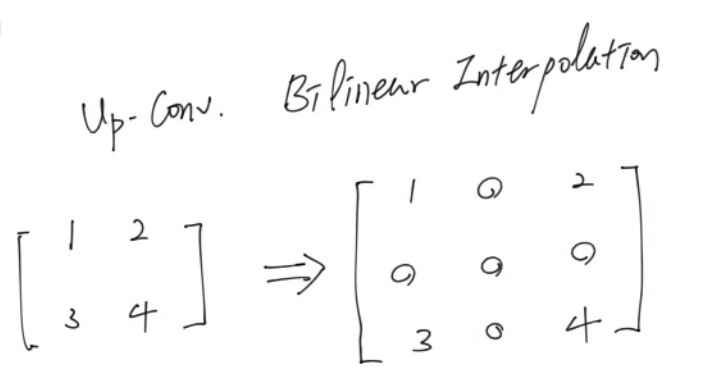
Decoder는 반대로 feature map을 확대하는 방향으로 계산한다. 16x16이 256x256으로 커진다. 이를 Up-sampling이라고 한다.
앞서 소개했던 참고 페이지를 가보면, 아래와 같이 차원이 확장된다고 설명하고 있다.
Skip connection
중간에 동그라미처럼 비어버린 부분을 interpolation을 통해 채울수 있긴 하지만 정화하진 않다. Encoder에서 이미지의 크기가 여러번에 걸쳐 줄여졌기 때문이다. 이렇게 잃어버린 위치정보를 복구하기 위해 중요한 아이디어가 바로 Skip connection이다.
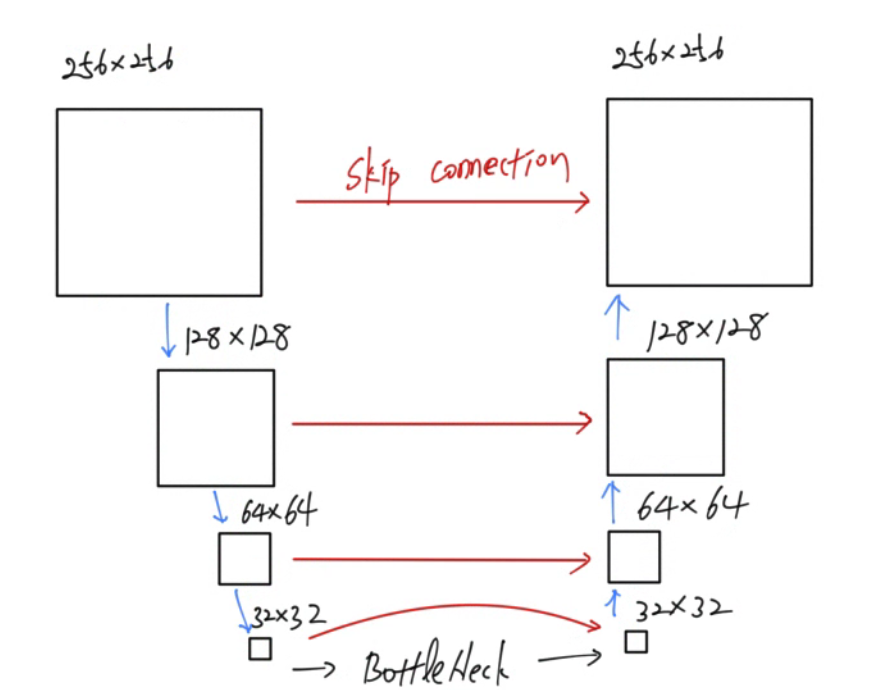
feature를 channel방향으로 concatenate 한다고 하는데, 이걸 파이토치에서는 다음과 같이 구현하게 된다.
x = torch.cat([decoder_feature, encoder_feature], dim=1)
이러한 개념을 가지고, 이제 실제 코드 구현에 들어가보자.
코드 구현
U-Net 정의하기
이제 실제 어떻게 구현되는지 훑어보자. 생각보다 간단하다.
동작환경
파이썬과 Pytorch 기준으로 진행해보자.
우선 구동환경을 설정해본다. 필수 라이브러리를 import하고 CUDA device를 잡자.
import torch
import torch.nn as nn
import torch.nn.functional as F

print(torch.__version__)
print("CUDA available:", torch.cuda.is_available())

device = torch.device(
    "cuda" if torch.cuda.is_available() else "cpu"
)

print(device)
Double convolution block
앞서서 Encoder의 구현에서 Conv-ReLU-Conv-ReLU-Pooling 을 반복한다고 설명했다. 이 반복되는 부분을 미리 함수로 만들어 두면 편하다. 이후 몇번에 걸쳐서 이 함수가 불러지는지 한번 체크도 해보자.
#padding = 1, kernel_size = 3, stride = 1
#3x3 conv를 했지만, padding을 1로 주었기 때문에, output size는 input size와 동일하게 유지됨

class DoubleConv(nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()

        # DoubleConv은 두 개의 3x3 convolution layer를 연속적으로 적용하는 block임
        # 첫 번째 convolution layer는 입력 채널 수를 out_channels로 변환하고, 두 번째 convolution layer는 out_channels를 유지함
        # padding을 1로 주어, output size가 input size와 동일하게 유지되도록 함
        # ReLU activation function을 적용하여 non-linearity를 추가함
        self.conv = nn.Sequential(
            nn.Conv2d(
                in_channels,
                out_channels,
                kernel_size=3,
                padding=1
            ),
            nn.ReLU(inplace=True),

            nn.Conv2d(
                out_channels,
                out_channels,
                kernel_size=3,
                padding=1
            ),
            nn.ReLU(inplace=True)
        )
    # forward method는 DoubleConv block의 순전파를 정의함
    # input x는 이전 block에서 나온 feature map이며, conv를 통해 feature map의
    # channel 수를 늘리고, ReLU activation function을 적용함
    def forward(self, x):
        return self.conv(x)
Encoder
이제 실제 시작부분이다. Encoder를 구현해보자. 막상 구현해보니, Double convolution은 한번만쓰네. 흠.
# return 에 있는 feature, pooled 는 각각 encoder block에서 나온 feature map과 pooling된 feature map을 의미함
# feature는 skip connection에 사용되고, pooled는 다음 encoder block으로 전달됨

class EncoderBlock(nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()
        # DoubleConv을 통해 feature map의 channel 수를 늘림
        self.conv = DoubleConv(
            in_channels,
            out_channels
        )
        # MaxPool2d를 통해 feature map의 spatial size를 줄임
        self.pool = nn.MaxPool2d(2)

    # forward method는 encoder block의 순전파를 정의함
    # input x는 이전 block에서 나온 feature map이며, conv를 통해 feature map의
    # channel 수를 늘리고, pool을 통해 feature map의 spatial size를 줄임
    def forward(self, x):

        feature = self.conv(x)

        pooled = self.pool(feature)

        return feature, pooled
Decoder
Encoder를 구현했으면, 이제 Decoder를 구현해보자.
class DecoderBlock(nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()

        # upsampling을 위해 ConvTranspose2d를 사용함
        self.up = nn.ConvTranspose2d(
            in_channels,
            out_channels,
            kernel_size=2,
            stride=2
        )

        # conv를 통해 feature map의 channel 수를 줄임
        self.conv = DoubleConv(
            out_channels * 2,
            out_channels
        )
    # forward method는 decoder block의 순전파를 정의함
    # input x는 bottleneck에서 나온 feature map이며, skip은 encoder block에서 나온
    # feature map을 의미함

    def forward(self, x, skip):

        x = self.up(x)

        print("x shape:", x.shape)
        x = torch.cat(
            [x, skip],
            dim=1
        )
        print("x shape after concat:", x.shape)

        x = self.conv(x)

        return x
U-Net Framework
Encoder와 Decoder가 구현되었으면, 이제 이것 전체를 연결하는 프레임워크를 구성하자. Skip connection은 여기서 구현된다.
class UNet(nn.Module):
    def __init__(self, in_channels=3, num_classes=1):
        super().__init__()
        #class EncoderBlock(in_channels, out_channels)
        # in_channels는 input feature map의 channel 수, out_channels는 output feature map의 channel 수를 의미함:
        self.enc1 = EncoderBlock(in_channels, 64)
        self.enc2 = EncoderBlock(64, 128)
        self.enc3 = EncoderBlock(128, 256)

        # bottleneck은 encoder의 마지막 block에서 나온 feature map을 받아서,
        # decoder로 전달하기 전에 feature map의 channel 수를 늘려주는 역할을 함
        self.bottleneck = DoubleConv(
            256,
            512
        )
        # decoder block은 bottleneck에서 나온 feature map을 받아서,
        # skip connection으로 전달된 feature map과 concat한 후, conv를 통해 output feature map을 생성함
        self.dec3 = DecoderBlock(512, 256)
        self.dec2 = DecoderBlock(256, 128)
        self.dec1 = DecoderBlock(128, 64)

        # 1x1 convolution layer
        # output feature map의 channel 수를 num_classes로 변환함
        # output layer는 decoder block에서 나온 feature map을 받아서,
        # 최종적으로 segmentation mask를 생성함
        # ex : [B, 64, 256, 256] -> [B, num_classes, 256, 256]
        self.output = nn.Conv2d(
            64,
            num_classes,
            kernel_size=1
        )

    # forward method는 UNet 모델의 순전파를 정의함
    # input x는 입력 이미지이며, 각 encoder block을 거치면서 feature map과 pooled feature map을 생성함
    # bottleneck을 거친 후, decoder block을 통해 feature map을 복원하고
    # skip connection으로 전달된 feature map과 concat하여 최종적으로 segmentation mask를 생성함
    def forward(self, x):

        s1, x = self.enc1(x)
        s2, x = self.enc2(x)
        s3, x = self.enc3(x)

        x = self.bottleneck(x)

        x = self.dec3(x, s3)
        x = self.dec2(x, s2)
        x = self.dec1(x, s1)

        return self.output(x)

model = UNet(
    in_channels=3,
    num_classes=1
).to(device)

model
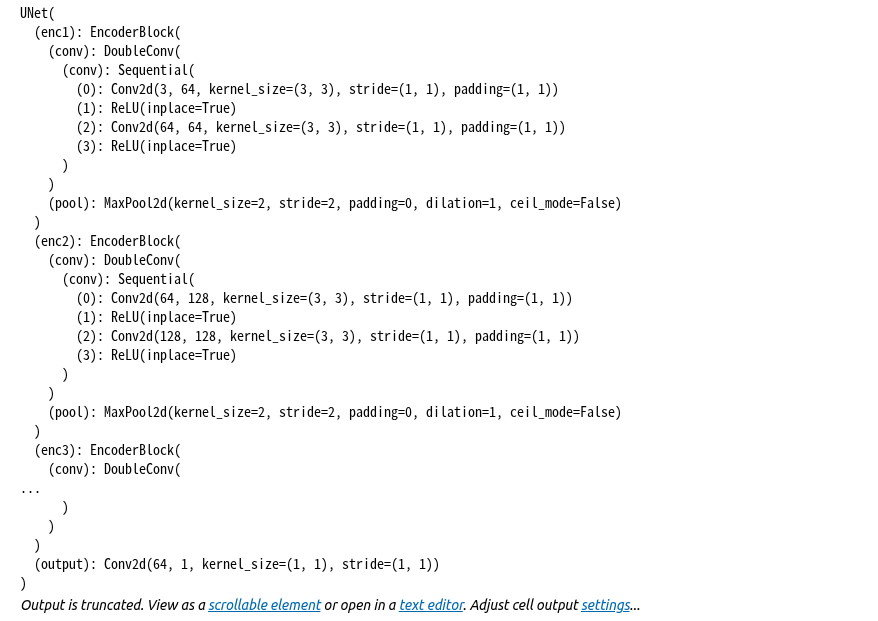
추가적으로 shape를 한번 확인해보자. 검산이다.
x = torch.randn(
    1, 3, 256, 256
).to(device)

with torch.no_grad():
    y = model(x)

print("Input :", x.shape)
print("Output:", y.shape)
여기까지 해서 U-Net의 형태를 구현했다. 이젠 간단한 데이터를 넣어서 학습하고, 어떻게 결과가 나오는지 확인해보자.
U-Net 학습하기
실제 데이터를 들어가기 전, 간단한 Segmentation Dataset을 만들어보자.
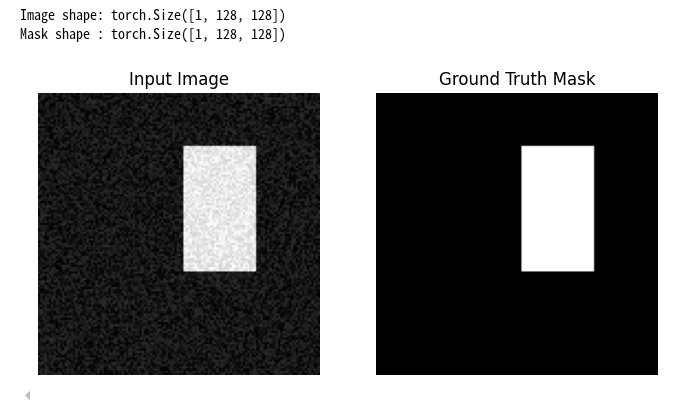
이미지 안에 임의의 사각형을 만들고, U-Net이 그 사각형을 Segmentation을 하도록 해보자. 배경은 0으로, 객채는 1로 되는 간단한 행렬을 넣어본다.
합성 데이터셋 만들기
그런데 학습을 하려면 뭔가 데이터가 있어야 하지 않나. Random 함수를 이용해서 한번 구현해보자.
import numpy as np
import matplotlib.pyplot as plt

import torch
import torch.nn as nn

from torch.utils.data import Dataset, DataLoader

# 합성 데이터셋 생성
class RectangleDataset(Dataset):
    def __init__(self, num_samples=500, image_size=128):
        self.num_samples = num_samples
        self.image_size = image_size

    def __len__(self):
        return self.num_samples

    # 데이터셋의 각 샘플을 생성하는 메서드
    # Random하게 밝은 사각형을 생성하고, 해당 사각형의 위치를 나타내는 mask를 생성함
    def __getitem__(self, idx):

        H = self.image_size
        W = self.image_size

        # 입력 이미지
        image = np.random.rand(H, W) * 0.15

        # Ground Truth Mask
        mask = np.zeros((H, W), dtype=np.float32)

        # 사각형 크기
        rect_w = np.random.randint(20, 60)
        rect_h = np.random.randint(20, 60)

        # 사각형 위치
        x1 = np.random.randint(5, W - rect_w - 5)
        y1 = np.random.randint(5, H - rect_h - 5)

        x2 = x1 + rect_w
        y2 = y1 + rect_h

        # 이미지 안에 밝은 사각형 생성
        image[y1:y2, x1:x2] += 0.7

        # Mask
        mask[y1:y2, x1:x2] = 1.0

        image = np.clip(image, 0, 1)

        # [H, W] → [1, H, W]
        image = torch.tensor(image, dtype=torch.float32).unsqueeze(0)
        mask = torch.tensor(mask, dtype=torch.float32).unsqueeze(0)

        return image, mask
이렇게 하면 Dataset을 선언하고, 매번 item을 불러올때마다 사각형 이미지가 랜덤하게 만들어져 나온다. … 오 Chatgpt.신박한데?
데이터셋을 확인해보면 다음과 같다.
dataset = RectangleDataset(
    num_samples=500,
    image_size=128
)

image, mask = dataset[0]

print("Image shape:", image.shape)
print("Mask shape :", mask.shape)

fig, axes = plt.subplots(1, 2, figsize=(8, 4))

axes[0].imshow(image.squeeze(), cmap="gray")
axes[0].set_title("Input Image")
axes[0].axis("off")

axes[1].imshow(mask.squeeze(), cmap="gray")
axes[1].set_title("Ground Truth Mask")
axes[1].axis("off")

plt.show()
Dataloader
이제 데이터를 batch단위로 공급해보자.
train_loader = DataLoader(
    dataset,
    batch_size=8,
    shuffle=True
)

# DataLoader를 통해 batch 단위로 데이터를 가져올 수 있음
images, masks = next(iter(train_loader))

print(images.shape)
print(masks.shape)
모델 생성
앞서 만든 모델을 사용해보자.
device = torch.device(
    "cuda" if torch.cuda.is_available()
    else "cpu"
)

model = UNet(
    in_channels=1,
    num_classes=1
).to(device)
Loss function, Optimizer 정의
training을 위해선 Loss function과 Optimizer를 정의해야 한다. 0과 1의 이진 구분이므로, Binary segmentation에 많이 사용하는 loss를 쓰자.
Optimizer는 Adam으로 한다.
criterion = nn.BCEWithLogitsLoss()
optimizer = torch.optim.Adam(
    model.parameters(),
    lr=1e-3
)
학습 전 Prediction
아직 아무것도 학습하지 않은 네트워크는 어떤지 한번 살펴보자.
Prediction을 해보면 알 수 있다.
# 이미지 하나를 가져와서 모델에 넣고, 예측 결과를 시각화함
image, mask = dataset[0]

input_image = image.unsqueeze(0).to(device)

model.eval()

with torch.no_grad():
    output = model(input_image)
    #signmoid 함수를 통해 output을 확률로 변환함
    probability = torch.sigmoid(output)
    # 0.5를 기준으로 thresholding하여 binary mask를 생성함
    prediction = (probability > 0.5).float()

fig, axes = plt.subplots(1, 3,figsize=(12, 4))

axes[0].imshow(image.squeeze(),cmap="gray")
axes[0].set_title("Input")
axes[1].imshow(mask.squeeze(),cmap="gray")
axes[1].set_title("Ground Truth")
axes[2].imshow(prediction.cpu().squeeze(),cmap="gray")
axes[2].set_title("Prediction (Before Training)")

for ax in axes:
    ax.axis("off")

plt.show()
시각화의 결과는 다음과 같다.
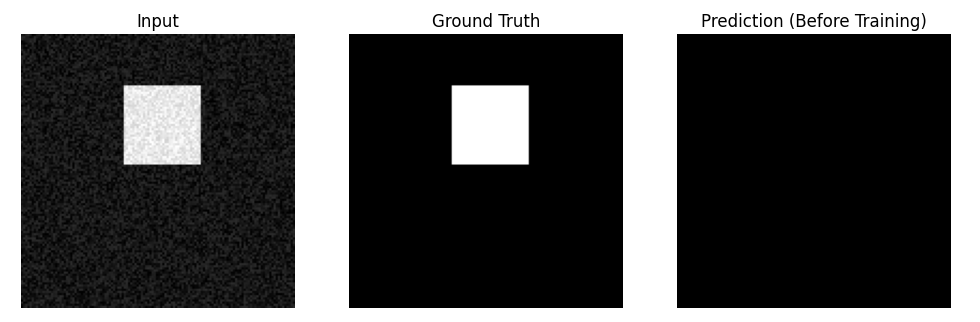
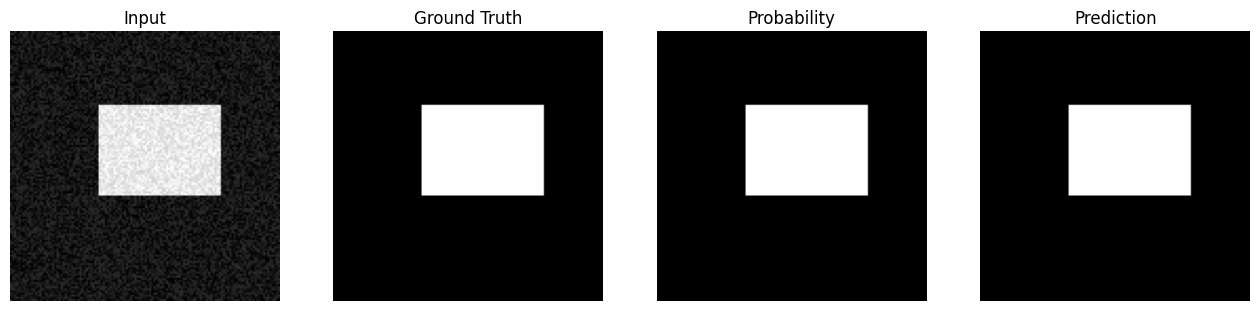
중간에 보면, Probability라는 변수가 등장한다. 이건 Probability map을 뜻하는 변수다. 이게 등장한 이유는 U-Net의 출력값이 0/1의 단순한 2진값이 아닌 각 픽셀에 대한 확율값을 출력하기 때문이다.(네트워크의 출력이므로 어찌보면 당연한 결과다.)
예를 들면 이런식이다.

0.01  0.02  0.08  0.10
0.03  0.45  0.82  0.90
0.01  0.76  0.98  0.95
0.02  0.10  0.22  0.05
따라서, 확율이 0.5보다 크면 1, 작으면 0으로 바꿔 줄 필요가 있다.(probability > 0.5) 그러면 Binary Mask가 된다.
Training loop
이제 학습을 진행해본다.
num_epochs = 10
loss_history = []

for epoch in range(num_epochs):

    model.train()

    epoch_loss = 0.0

    for images, masks in train_loader:

        images = images.to(device)
        masks = masks.to(device)

        # -----------------
        # 1. Gradient 초기화
        # -----------------

        optimizer.zero_grad()

        # -----------------
        # 2. Forward
        # -----------------

        outputs = model(images)

        # -----------------
        # 3. Loss
        # -----------------

        loss = criterion(outputs, masks)

        # -----------------
        # 4. Backpropagation
        # -----------------

        loss.backward()

        # -----------------
        # 5. Weight update
        # -----------------

        optimizer.step()

        epoch_loss += loss.item()

    epoch_loss /= len(train_loader)

    loss_history.append(epoch_loss)

    print(
        f"Epoch [{epoch+1}/{num_epochs}] "
        f"Loss: {epoch_loss:.4f}"
    )

plt.figure(figsize=(6, 4))

plt.plot(loss_history)

plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.title("Training Loss")

plt.grid()

plt.show()
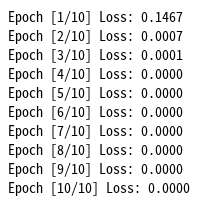
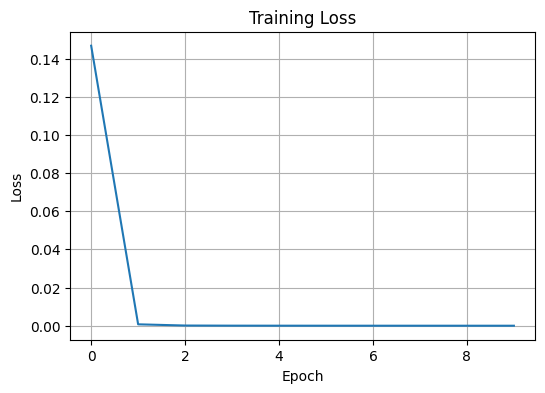
학습하면 loss가 굉장히 빠르게 수렴함을 알 수 있다.
Test
이제 테스트를 해보자. 원래 일반적인 데이터셋이라면 테스트용 데이터셋을 따로 구하겠지만, 이건 랜덤으로 만든 데이터셋이므로, 그냥 한번 더 만들면 된다.
test_dataset = RectangleDataset(
    num_samples=20,
    image_size=128
)

image, mask = test_dataset[0]

input_image = image.unsqueeze(0).to(device)

model.eval()

with torch.no_grad():

    output = model(input_image)

    probability = torch.sigmoid(output)

    prediction = (
        probability > 0.5
    ).float()
아래는 시각화용 코드다.
fig, axes = plt.subplots(1, 4,figsize=(16, 4))

axes[0].imshow(image.squeeze(),cmap="gray")
axes[0].set_title("Input")

axes[1].imshow(mask.squeeze(),cmap="gray")
axes[1].set_title("Ground Truth")

axes[2].imshow(probability.cpu().squeeze(),cmap="gray",vmin=0,vmax=1)
axes[2].set_title("Probability")

axes[3].imshow(prediction.cpu().squeeze(),cmap="gray")
axes[3].set_title("Prediction")

for ax in axes:
    ax.axis("off")

plt.show()
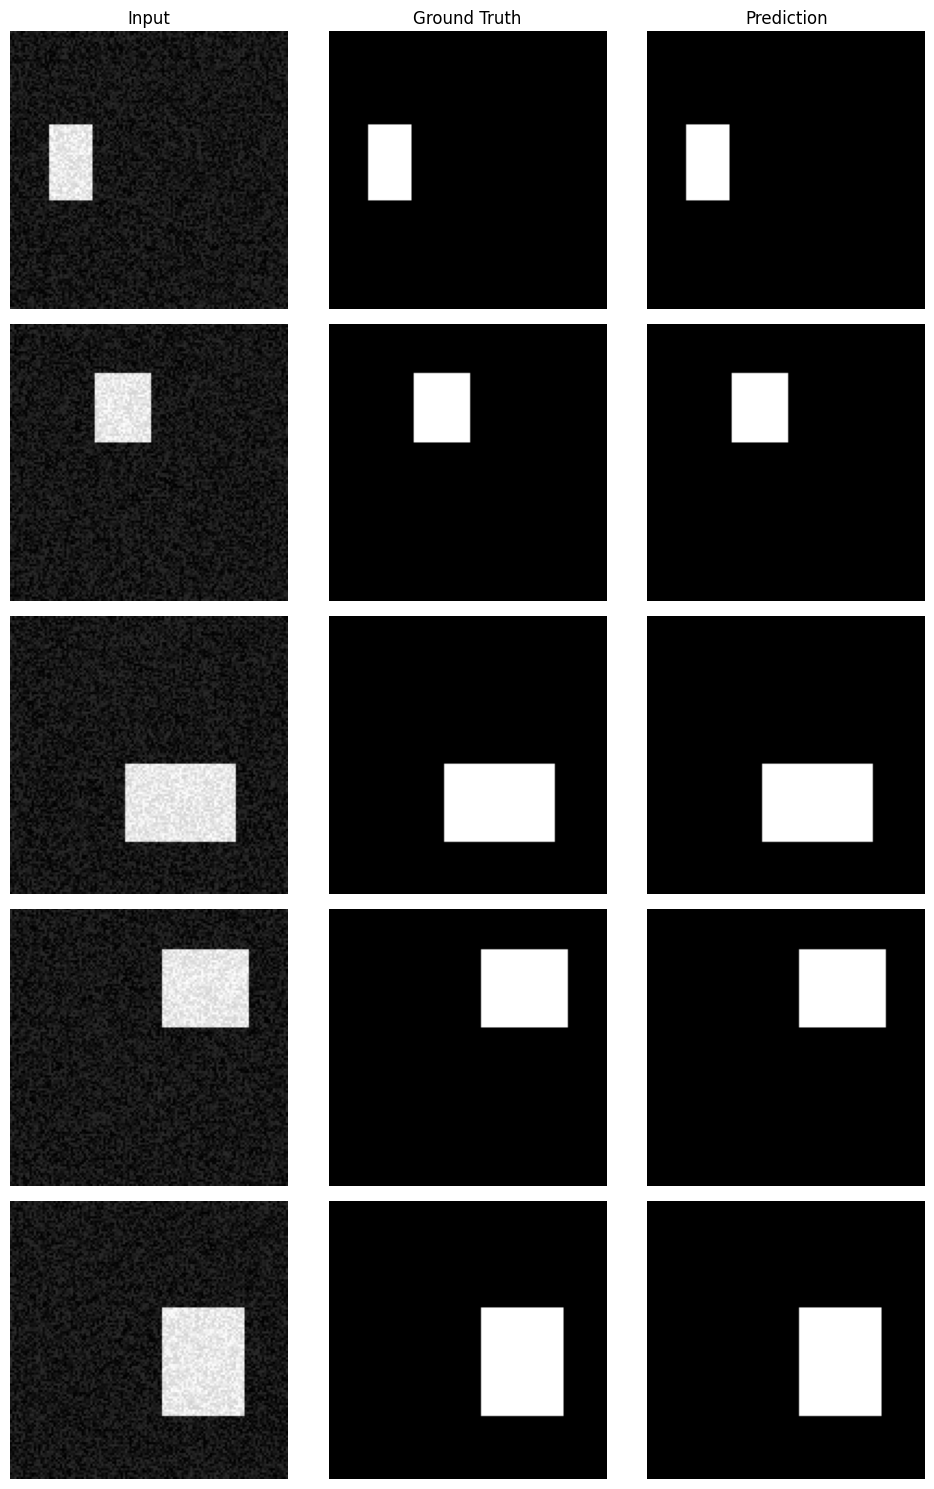
결과를 보면 상당히 깔끔하게 잘 하는걸 알 수 있다.
성능지표 (1) IoU
가장 대표적인 성능지표인 Accuracy가 있는데, 왜 IoU나 Dice같은 지표를 사용하는 것일까. Segmentation에서는 일반적인 accuracy가 상당히 위험할 수 있다.
Accuracy의 정의는 다음과 같다.
\(\begin{align*} Accuracy &= \frac{맞게 예측한 개수}{전체 예측개수}\\ &= \frac{TP + TN}{TP+TN+FP+FN} \\ \end{align*}\)
- TP: 실제 1을 1로 맞춤
- TN: 실제 0을 0으로 맞춤
- FP: 실제 0인데 1이라고 예측
- FN: 실제 1인데 0이라고 예측
이미지에서 배경이 95%, 벽이 5% 로 구성되어있다 가정해보자. 모델이 모든 pixel을 배경이라고 예측해버리면 TP = 0, TN = 0.95, FP = 0.00, FN = 0.05이므로 최종 정확도는 95%가 나오게 된다. 그러나 원래 우리는 벽을 예측하려 했다. 벽 예측에선 0%가 되므로, 단순히 Accuracy를 쓴다는건 문제가 된다.
따라서 Segmentation에서는 IoU와 Dice를 성능지표로 자주 쓰게 된다.
IoU의 뜻은 Intersection over Union이다. 단어 약자를 잘 외워야 하는데 매번 그걸 까먹는다. 늙크큰가.. 노래만 떠오르네. 누군 가수를 떠올리려나.
교집합 / 합집합. GT와 Prediction간의 겹침이 얼마나 잘 맞는지 확인하는 과정이다. 연산의 입력값은 Prediction과 GT다.
\[IoU = \frac{Prediction \cap GT}{Prediction \cup GT}\]함수는 다음과 같이 정의할 수 있다. 데이터가 0과 1로만 되어있으므로, 두 데이터를 곱셈처리하면, 교집합이 된다. 마찬가지로 덧샘을 하면(아님 or연산을 하던가) 합집합이 된다. 그리고 그 둘의 나눗셈을 진행하면 된다.
def iou_score(pred, target, eps=1e-7):

    pred = pred.float()
    target = target.float()

    intersection = (pred * target).sum()

    union = (pred + target).clamp(0, 1).sum()

    iou = (intersection + eps) / (union + eps)

    return iou.item()


iou = iou_score(
    prediction.cpu(),
    mask.unsqueeze(0)
)

print("IoU:", iou)
성능지표 (2) Dice
Dice score도 자주 쓰는 성능지표다. 민감도(Sensitivity/Recall)와 정밀도(Precision)의 조화평균(Harmonic mean)과 수학적으로 같다.
분류 모델의 평가 지표인 F1 Score는 정밀도(Precision)와 재현율(Recall)의 조화평균인데, 이 F1 Score와 Dice Score는 개념 및 계산 결과가 완전히 일치한다.
단순 산술평균과 달리, 두 지표 중 어느 한쪽이 0에 가까워지면 값도 함께 급격히 떨어지므로 모델의 성능을 더 엄격하고 균형 있게 평가할 수 있기 때문에 조화평균의 성격을 띤다.
정의는 다음과 같다.
\[Dice = \frac{2|A \cap B|}{|A| + |B|}\]바꿔서 쓰면,
\[Dice = \frac{2 |Intersection| }{|Prediction| + |GT|}\]며, 완벽히 일치하면 1이 된다.
코드로 구현해보자.
def dice_score(pred, target, eps=1e-7):

    pred = pred.float()
    target = target.float()

    intersection = (pred * target).sum()

    #eps는 나눈셈 오류 방지를 위해 있는 작은 오차다.
    dice = (2 * intersection + eps) /
           ( pred.sum() + target.sum() + eps)

    return dice.item()

dice = dice_score(
    prediction.cpu(),
    mask.unsqueeze(0)
)

print("Dice:", dice)
성능 확인해보기
이제 저 두 성능지표를 테스트 데이터셋을 통해 다시 확인해보자.
test_loader = DataLoader(
    test_dataset,
    batch_size=1,
    shuffle=False
)

iou_list = []
dice_list = []

model.eval()

with torch.no_grad():

    for images, masks in test_loader:

        images = images.to(device)
        masks = masks.to(device)

        outputs = model(images)

        probs = torch.sigmoid(outputs)

        preds = (
            probs > 0.5
        ).float()

        iou = iou_score(
            preds.cpu(),
            masks.cpu()
        )

        dice = dice_score(
            preds.cpu(),
            masks.cpu()
        )

        iou_list.append(iou)
        dice_list.append(dice)

print(
    "Mean IoU:",
    np.mean(iou_list)
)

print(
    "Mean Dice:",
    np.mean(dice_list)
)
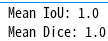
지금은 간단한 데이터들이므로, 매우 훌륭한(?)성능을 보여준다.
다음 코드로 시각화 해보면 더 잘 와닿는다.
fig, axes = plt.subplots(
    5, 3,
    figsize=(10, 15)
)

model.eval()

for i in range(5):

    image, mask = test_dataset[i]

    x = image.unsqueeze(0).to(device)

    with torch.no_grad():

        output = model(x)

        prob = torch.sigmoid(output)

        pred = (
            prob > 0.5
        ).float()

    axes[i, 0].imshow(
        image.squeeze(),
        cmap="gray"
    )

    axes[i, 1].imshow(
        mask.squeeze(),
        cmap="gray"
    )

    axes[i, 2].imshow(
        pred.cpu().squeeze(),
        cmap="gray"
    )

    axes[i, 0].axis("off")
    axes[i, 1].axis("off")
    axes[i, 2].axis("off")

axes[0, 0].set_title("Input")
axes[0, 1].set_title("Ground Truth")
axes[0, 2].set_title("Prediction")

plt.tight_layout()
plt.show()
Day 1 Quiz.
-
U-Net의 출력에 바로 Sigmoid를 적용하지 않고 BCEWithLogitsLoss를 사용하는 이유는?
-
다음 출력 shape은 무엇을 의미하는가?
[8, 1, 128, 128]
-
왜 segmentation 문제에서 단순 accuracy만 사용하면 위험한가?
-
다음 세 가지의 차이는?
Logit
Probability
Binary Mask
-
IoU가 1.0이라는 것은 무엇을 의미하는가?
-
다음의 object들을 분류하려 한다. 몇 개의 output channel이 필요한가?
Background
Wall
Door
Window
Room
Summary
-
Segmentation은 pixel classification이다.
-
U-Net은 Encoder Bottleneck Decoder Skip Connection 으로 구성된다.
-
Encoder는 feature를 압축한다.
-
Decoder는 spatial resolution을 복원한다.
-
Skip Connection은 세밀한 위치 정보를 전달한다.
-
U-Net output은 logit이다.
-
Binary training에서는 BCEWithLogitsLoss를 사용할 수 있다.
-
Inference에서는 Logit ↓ Sigmoid ↓ Probability ↓ Threshold ↓ Mask
-
Segmentation 평가는 IoU / Dice를 많이 사용한다.
댓글남기기