Semantic Segmentation, U-Net Day 2
이미지에서 특정 패턴을 추출해보자.
들어가면서.
Day 1에서는 Random 함수로 0과 1로 된 행렬을 만들어 그걸로 테스트를 대신해봤다. 덕분에 빠른 학습과 완벽한 결과를 얻었지만, 실제 이미지는 0~255로 이루어진 RGB 형태의 픽셀인 경우가 많다. (물론 다른 더 고해상도도 있을 것이다.) 이제 실제 데이터셋을 이용해서 한번 진행해보도록 하자.
| Day | 핵심 주제 | 결과물 |
|---|---|---|
| 1일차 | CNN, Segmentation, U-Net 구조 | U-Net 구조 이해 + 직접 구현 |
| 2일차 | Dataset, Loss, Training | 간단한 Segmentation 모델 학습 |
| 3일차 | 건축도면 적용 | Wall/Door/Window Multi-class Segmentation |
| 4일차 | 대형 도면 + 후처리 + 정보 추출 | 도면 → Mask → Geometry → 정보 추출 Pipeline |
오늘 다룰 순서를 한번 훑어보자.
- Oxford-IIIT Pet 데이터셋 이해
- 데이터 다운로드 및 확인
- Image / Mask 구조 이해
- 전처리 및 Dataset 구성
- DataLoader 구성
- U-Net 구현
- Loss / Optimizer 설정
- Training
- 시각화와 IoU / Dice로 성능 평가
Day 2를 시작해본다.
Remind) Segmentation에 대한 이해
Classification 데이터는 Image/Label의 쌍으로구성되어있다. 예를 들자면 cat.jpg는 “cat”이고, dog.jpg는 “dog”인 것이다. 하지만 Segmentation은 다르다.
Segmantation은 Image/Mask의 쌍으로 되어있다. 그래서 데이터셋을 보면 두개의 이미지가 있는데, 하나가 Input이고 하나가 Ground Truth, 혹은 Mask라 한다. 따라서, Image가 [3,H,W] 의 구조를 가진다고 한다면, Mask 는 [C,H,W]의 형태를 가진다. 여기서 C는 Class의 개수가 된다.
그 구조를 알아보기 위해 가장 전형적인 데이터셋을 하나 구해보자.
1. Oxford-IIIT 데이터셋
Oxford-IIIT 은 Segmentation 용이나 혹은 Classification목적의 학습 데이터다. Pet 데이터셋의 마스크(Mask)는 픽셀 단위로 전경(동물)과 배경, 그리고 경계선을 구분하는 트리맵(Trimap) 형태의 분할(Segmentation) 어노테이션으로 제공된다. https://www.robots.ox.ac.uk/~vgg/data/pets/
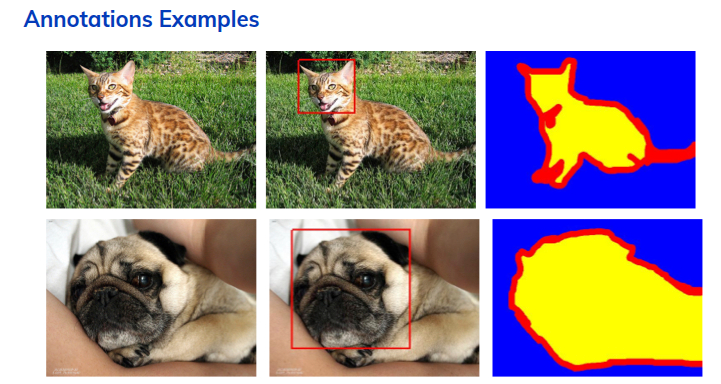
앞서 설명하길 Trimap이라고 했다. 즉 3개의 영역으로 나뉜다는 소리다.
- 1 : Pet
- 2 : Background
- 3 : Boundary
이걸 좀 단순화 시켜서 Pet 만 뽑아내는 Binary문제로 바꿔서 연습을 해보자.
\[y_{ij} = \begin{cases} 1 & \text{pet pixel} \\ 0 & \text{otherwise} \end{cases}\]이걸 위해서는 데이터셋을 받아 전처리를 한번 진행할 필요가 있다. 이런 사전 지식을 가지고 이제 부분 코드로 진행해보자.
동작 환경 꾸미기
필요한 라이브러리를 불러오자.
Day1에서 안썼던 torchvision이 필요하다.
import torch
import torch.nn as nn

from torch.utils.data import DataLoader
from torchvision import datasets
from torchvision.transforms import v2

import matplotlib.pyplot as plt
import numpy as np

print("PyTorch version:", torch.__version__)

device = torch.device("cuda" if torch.cuda.is_availabel()) else "cpu"

print(device)
2. 데이터셋의 다운로드
OxfordIIIT Pet 데이터셋은 torchvision에서 제공한다. 이때 주의할건 받는 데이터셋 타입인데, 반드시 “segmentation”이라고 해야 mask 데이터를 받을 수 있다. 잘못하면 classfication용 label데이터를 받을 수 있으므로 주의하자.
from torchvision.datasets import OxfordIIITPet

train_raw = OxfordIIITPet(
    root="./data",
    split="trainval",
    target_types="segmentation",
    download=True
)

test_raw = OxfordIIITPet(
    root="./data",
    split="test",
    target_types="segmentation",
    download=True
)

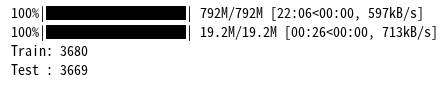
print("Train:", len(train_raw))
print("Test :", len(test_raw))
데이터셋은 약 800MB 정도의 용량을 가지고 있다. 가끔 아무 생각없이 돌리다가 용량 초과될때가 있는데, 미리 주의하자.
3. Image / Mask 구조 이해
이미지와 마스크 확인
데이터를 하나 꺼내보자. 왜, 한번쯤은 보고 싶지않은가. 그래야 한다.
image, mask = train_raw[0]

print(type(image))
print(type(mask))

print("Image size:", image.size)
print("Mask size :", mask.size)

fig, axes = plt.subplots(1, 2, figsize=(10, 5))

axes[0].imshow(image)
axes[0].set_title("Image")
axes[0].axis("off")

axes[1].imshow(mask, cmap="gray")
axes[1].set_title("Original Trimap")
axes[1].axis("off")

plt.show()
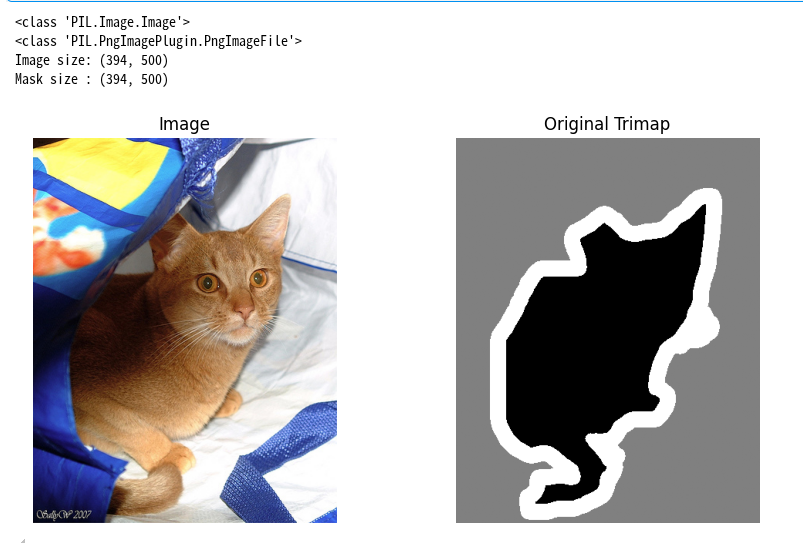
이미지로 잘 받아졌고, 이미지 사이즈와 Mask 사이즈가 동일함을 확인했다. 고양이가 오른쪽 trimap에서 검은색으로 칠해졌고, boundary가 흰색으로 나왔다. 0,1,2로 잘 구분되어있는 것이다.
Mask는 어떻게 되어있을까. 한번 보자.
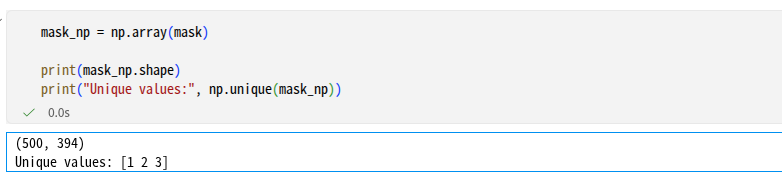
1,2,3 값으로 들어가있음을 확인 할 수 있다.
Mask의 Resize
여기서 하나 짚고 넘어가야 할 문제가 있다. Segmentation에서 매우 중요한 개념이다.
이제 학습을 들어가야 하는데, 모두들 알다시피 학습에 들어가는 입력값들은 일정한 형태로 통일되어야 한다. 네트워크 파라미터들에 맞추어야 하기때문에 Resize를 해야 하는데, 문제는 이미지의 크기가 제각각이란거다.
아, 그럼 일괄적으로 Resize하면 되나요?? 라는 질문을 하는 순간 문제가 발생한다.
일반 사진은 Resize를 실행할때 픽셀 사이를 처리할때 보간법(interpolation)을 사용한다. 그래야 자연스럽게 확대/축소가 가능하기때문이다. 그러나 Segmentation의 mask에서는 이게 문제가 된다.
class값을 다시 상기해보자. 1,2,3만 들어가 있는데 1과 2 사이에 있다고 해서 1.5로 만들 수는 없는 노릇이다. 따라서 Mask 의 resize에서는 일반적으로 Nearest Neighbor interpolation를 사용한다. 잠시 후 코드에서 어떻게 적용되는지 눈여겨보자.
학습용 데이터의 형태
이번 실습에선 128 X 128의 형태로 진행하려 한다. 실전용 데이터도 아닌데 굳이 이미지크기를 키워 메모리를 잡아먹지 말자. 요새 메모리값 비싸다.
입력 Image tensor는 [c,H,W] 이므로 [3,128,128] 이 된다.(소문자 c로 썼다. color)
그리고 우리는 pet 부분만 잘라낼것이므로, binary mask는 [C,H,W], 즉 [1,128,128]이 되어야 한다.(대문자 C다. Class)
이제 원본 데이터셋을 우리가 사용할 방식에 맞게 줄이고 바꾸는 작업을 해보자.
4. 전처리 및 Dataset 구성
항상 전처리가 중요하다.
요리에도 재료 다듬기가 망하면 그 다음 요리도 망하듯, 학습에 있어서도 마찬가지다.
이제 Dataset 을 만들어보자.
우선
from torch.utils.data import Dataset
from torchvision.transforms import functional as TF
from torchvision.transforms import InterpolationMode


class PetSegmentationDataset(Dataset):
    # 데이터셋 초기화
    # 사용할 기본 데이터셋과 이미지 크기를 입력받음
    def __init__(self, base_dataset, image_size=(128, 128)):
        self.base_dataset = base_dataset
        self.image_size = image_size

    def __len__(self):
        return len(self.base_dataset)

    def __getitem__(self, idx):

        image, mask = self.base_dataset[idx]

        # -------------------------
        # Image preprocessing
        # -------------------------
        # 이미지 크기를 지정된 크기로 조정하고, tensor로 변환함
        # InterpolationMode.BILINEAR을 사용하여 이미지를 보간함. Mask와는 다르다.
        image = TF.resize(
            image,
            self.image_size,
            interpolation=InterpolationMode.BILINEAR
        )
        # Image를 tensor로 변환함
        image = TF.to_tensor(image)

        # -------------------------
        # Mask preprocessing
        # -------------------------
        # Mask는 InterpolationMode.NEAREST를 사용하여 보간함.
        mask = TF.resize(
            mask,
            self.image_size,
            interpolation=InterpolationMode.NEAREST
        )
        # Mask를 tensor로 변환하고, long 타입으로 변환함
        mask = torch.from_numpy(np.array(mask)).long()

        # Oxford Pet trimap:
        # 1 = pet
        # 2, 3 = non-pet
        # 0 = background
        # 따라서, pet 영역을 1로, 나머지 영역을 0으로 변환함.
        mask = (mask == 1).float()

        # [H, W] -> [1, H, W]
        mask = mask.unsqueeze(0)

        return image, mask
주목할 부분은 Mask를 interpolation할때, Torchvision 라이브러리를 이용해 바꾸고, 그 방법을 NEAREST를 쓴다는 것과(“interpolation=InterpolationMode.NEAREST”), Mask의 1,2,3중 1만 남기고 0으로 바꾼다는 것. (“mask = (mask == 1).float()”)
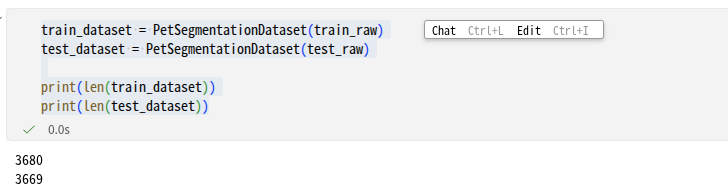
이제 이 데이터셋을 실제로 생성한다.
train_dataset = PetSegmentationDataset(train_raw)
test_dataset = PetSegmentationDataset(test_raw)

print(len(train_dataset))
print(len(test_dataset))
항상 중간중간에 shape를 확인해보길 권장한다.
image, mask = train_dataset[0]

print("Image shape:", image.shape)
print("Mask shape :", mask.shape)

print("Image dtype:", image.dtype)
print("Mask dtype :", mask.dtype)

print("Mask values:", torch.unique(mask))
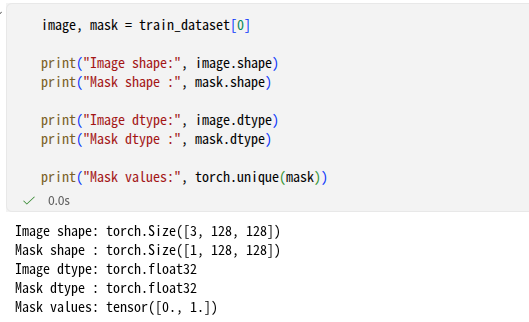
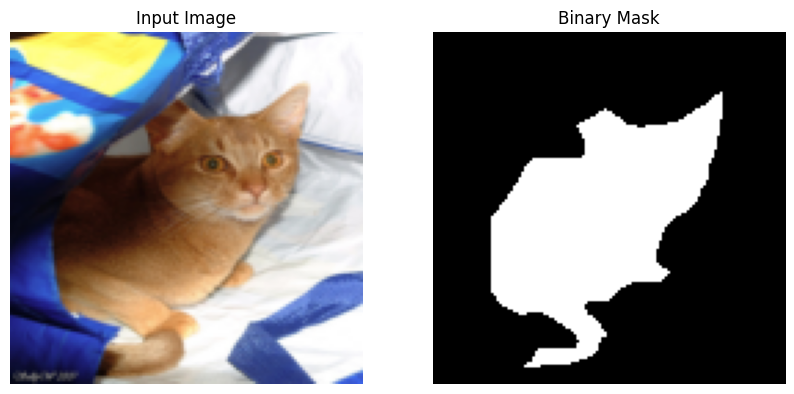
이제 전처리가 다 끝났다. 한번 눈으로 확인해보자.
image, mask = train_dataset[0]

fig, axes = plt.subplots(1, 2, figsize=(10, 5))

axes[0].imshow(image.permute(1, 2, 0))
axes[0].set_title("Input Image")
axes[0].axis("off")

axes[1].imshow(mask.squeeze(0), cmap="gray")
axes[1].set_title("Binary Mask")
axes[1].axis("off")

plt.show()
5. DataLoader 구성
이제 여러 이미지를 배치 단위로 모델에 넣어야 한다.
BATCH_SIZE = 8

train_loader = DataLoader(
    train_dataset,
    batch_size=BATCH_SIZE,
    shuffle=True,
    num_workers=0
)

test_loader = DataLoader(
    test_dataset,
    batch_size=BATCH_SIZE,
    shuffle=False,
    num_workers=0
)

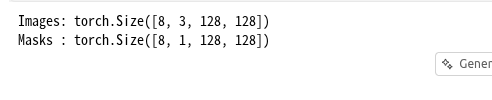
images, masks = next(iter(train_loader))

print("Images:", images.shape)
print("Masks :", masks.shape)
출력 형태를 확인해보면, (개,채,행,렬)의 순대로 잘 나옴을 알 수 있다. 혁펜하임 수업 들어봤으면 뭔 뜻인지 알….
이제 실제 네트워크를 구현하자.
6. U-Net 구현
Day 1에서도 해본 것들이다.
이제 입력으로 [8,3,128,128] 의 텐서가 입력되면, 네트워크를 거쳐 [8,1,128,128]의 logit이 출력된다. Day1에서 마지막층에 sigmoid함수를 쓰지 않아서 logit이 나오는거다. 다음번에는 BCEWithLogitsLoss() 함수를 바로 사용하자. 지금은 중간중간 눈으로 확인해야 할게 있으니 이렇게 나눠간다.
기본적인 블록은 conv -> ReLU -> Conv -> ReLU 이렇게 이어지는 DoubleConv를 기본으로 쓴다. 이번엔 각 Conv 연산뒤에 BatchNorm도 추가해준다. BatchNorm이 역할은 각자 검색해보자.
# 반복되는 conv 연산을 함수화한다.
class DoubleConv(nn.Module):
    def __init__(self, in_channels, out_channels):
        super().__init__()
        # DoubleConv는 두 개의 연속된 Conv2d, BatchNorm2d, ReLU 레이어로 구성된 블록을 정의한다.

        self.block = nn.Sequential(
            # Conv2d 레이어는 입력 채널 수, 출력 채널 수, 커널 크기, 패딩을 지정하여 정의한다.
            # kernel_size=3, padding=1은 입력과 출력의 공간적 크기를 동일하게 유지한다.
            # BatchNorm2d 레이어는 출력 채널 수를 지정하여 정의한다. 이는 각 채널의 평균과 분산을 정규화하여 학습을 안정화한다.
            # ReLU 레이어는 활성화 함수로 사용되며, inplace=True는 메모리 효율성을 위해 입력 텐서를 직접 수정한다.
            nn.Conv2d(
                in_channels,
                out_channels,
                kernel_size=3,
                padding=1
            ),
            nn.BatchNorm2d(out_channels), #이게 추가되었다.
            nn.ReLU(inplace=True),

            nn.Conv2d(
                out_channels,
                out_channels,
                kernel_size=3,
                padding=1
            ),
            nn.BatchNorm2d(out_channels),#이게 추가되었다.
            nn.ReLU(inplace=True)
        )

    def forward(self, x):
        return self.block(x)
위 코드에서 볼 수 있다시피, padding=1이므로 입출력의 H, W 크기는 동일하고, 다만 채널의 숫자만 증가/감소한다.
Encoder의 구조.
이번 실습에선, Encoder는 128x128 -> 64x64x -> 32x32 -> 16x16 ->8x8 까지 해서, 총 4번에 걸처 이미지 사이즈를 줄여나간다. 대신 채널 수는 3->64->128->256->512->1024로 늘여나간다. 공간정보는 줄어들고 특징정보가 늘어난다고 볼 수 있다.
pooling 은 nnMaxPool2d(2)를 사용한다.
Decoder
디코더는 반대로 8x8에서 시작해서 128x128까지 순차적으로 올린다. 단순히 사이즈를 올리는것 뿐만 아니라 Encoder와 연결되는 Skip connection도 있다. 이제 차근차근히 구현해보자.
class UNet
class UNet(nn.Module):
    def __init__(self, in_channels=3, out_channels=1):
        super().__init__()

        # -------------------------
        # Encoder
        # -------------------------
        # DoubleConv 블록을 사용하여 인코더의 각 단계에서 입력 채널 수와 출력 채널 수를 지정한다.
        # in_channels: 입력 이미지의 채널 수 (예: RGB 이미지의 경우 3)
        self.enc1 = DoubleConv(in_channels, 64)
        self.pool1 = nn.MaxPool2d(2)

        self.enc2 = DoubleConv(64, 128)
        self.pool2 = nn.MaxPool2d(2)

        self.enc3 = DoubleConv(128, 256)
        self.pool3 = nn.MaxPool2d(2)

        self.enc4 = DoubleConv(256, 512)
        self.pool4 = nn.MaxPool2d(2)

        # -------------------------
        # Bottleneck
        # -------------------------

        self.bottleneck = DoubleConv(512, 1024)

        # -------------------------
        # Decoder
        # -------------------------

        self.up4 = nn.ConvTranspose2d(
            1024, 512,
            kernel_size=2,
            stride=2
        )
        self.dec4 = DoubleConv(1024, 512)

        self.up3 = nn.ConvTranspose2d(
            512, 256,
            kernel_size=2,
            stride=2
        )
        self.dec3 = DoubleConv(512, 256)

        self.up2 = nn.ConvTranspose2d(
            256, 128,
            kernel_size=2,
            stride=2
        )
        self.dec2 = DoubleConv(256, 128)

        self.up1 = nn.ConvTranspose2d(
            128, 64,
            kernel_size=2,
            stride=2
        )
        self.dec1 = DoubleConv(128, 64)

        # -------------------------
        # Final output
        # -------------------------

        self.out_conv = nn.Conv2d(
            64,
            out_channels,
            kernel_size=1
        )

    def forward(self, x):

        # Encoder
        e1 = self.enc1(x) # layer 1, 사이즈는 [batch_size, 64, 128, 128] (H, W는 입력 이미지의 크기)
        e2 = self.enc2(self.pool1(e1)) # layer 2, 사이즈는 [batch_size, 128, 64, 64]
        e3 = self.enc3(self.pool2(e2)) # layer 3, 사이즈는 [batch_size, 256, 32, 32]
        e4 = self.enc4(self.pool3(e3)) # layer 4, 사이즈는 [batch_size, 512, 16, 16]

        # Bottleneck
        b = self.bottleneck( self.pool4(e4)) # layer 5, 사이즈는 [batch_size, 1024, 8, 8]

        # Decoder 4
        d4 = self.up4(b) # layer 4, 사이즈는 [batch_size, 512, 16, 16]
        d4 = torch.cat([d4, e4], dim=1) #skip connection 연결된 encoder의 사이즈는 [batch_size, 1024, 16, 16]
        d4 = self.dec4(d4)

        # Decoder 3
        d3 = self.up3(d4) # layer 3, 사이즈는 [batch_size, 256, 32, 32]
        d3 = torch.cat([d3, e3], dim=1) #skip connection 연결된 encoder의 사이즈는 [batch_size, 512, 32, 32]
        d3 = self.dec3(d3)

        # Decoder 2
        d2 = self.up2(d3) # layer 2, 사이즈는 [batch_size, 128, 64, 64]
        d2 = torch.cat([d2, e2], dim=1) #skip connection 연결된 encoder의 사이즈는 [batch_size, 256, 64, 64]
        d2 = self.dec2(d2)

        # Decoder 1
        d1 = self.up1(d2) # layer 1, 사이즈는 [batch_size, 64, 128, 128]
        d1 = torch.cat([d1, e1], dim=1) #skip connection 연결된 encoder의 사이즈는 [batch_size, 128, 128, 128]
        d1 = self.dec1(d1)

        # Logit output
        logits = self.out_conv(d1)
        #최종 출력 shape는 [batch_size, out_channels, 128, 128]이 된다.
        #여기서 out_channels는 1로 설정되어 있으므로 최종 출력은 [batch_size, 1, 128, 128]이 된다.

        return logits
여기서 신기한걸 짚고 넘어가보자. skip connection의 채널은 왜 두배가 되는가.
예를 들어 Decoder에서 d4 = self.up4(b)를 실행하면, d4.shape는 [Batch, 512, 16, 16]가 된다.
마찬가지로 Encdoer에서 저장한 e4 역시 [Batch, 512, 16, 16]의 형태를 가진다. 이 두개를 concat 하므로(torch.cat([d4, e4], dim=1)) 채널의 개수가 2배가 된다. dim=1 이므로 채널방향으로 주욱 이어붙이는 형태가 된다.
그래서 , dec4 의 계산 입력값을 보게 되면, self.dec4 = DoubleConv(1024, 512)가 됨을 알 수 있다.
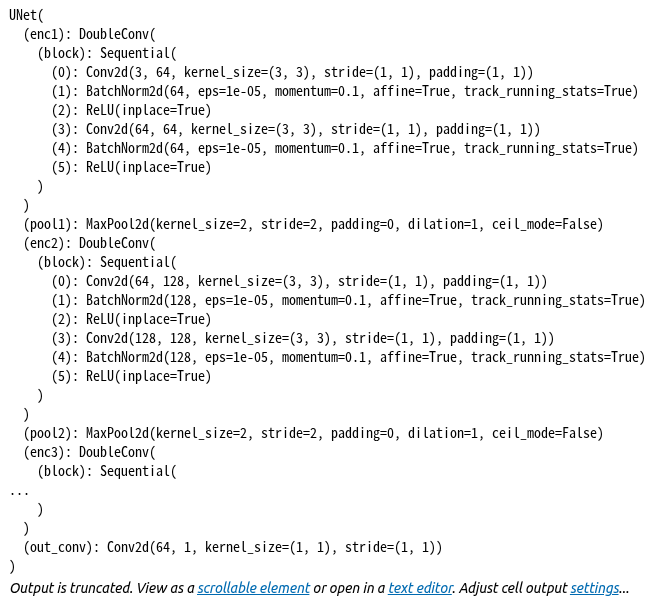
model 생성
이제 모델을 생성하자.
model = UNet(
    in_channels=3,
    out_channels=1
).to(device)

print(model)
여담이지만, 파라미터가 몇개인지 확인해볼 수도 있다.
num_params = sum(
    p.numel()
    for p in model.parameters()
    if p.requires_grad
)
print(f"Trainable parameters: {num_params:,}")
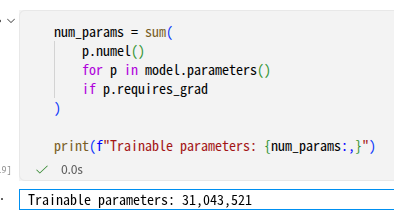
이 개수만큼 메모리를 잡아먹는다고 보면 된다.
이제 forward 테스트를 해보면서, 잘 연결되었는지 확인해보자.
Forward test
각 구성 모듈간의 연결이 정상인지 확인해보자.
images, masks = next(iter(train_loader))

images = images.to(device)
masks = masks.to(device)

with torch.no_grad():
    logits = model(images)

print("Input :", images.shape)
print("Target:", masks.shape)
print("Output:", logits.shape)
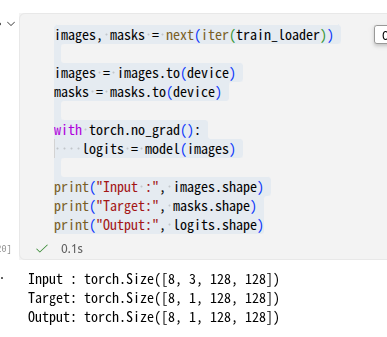
채널 3개가 들어가서 최종 출력 채널은 1개다. Pet만 구분하는것이니, 잘 연결되었다고 볼 수 있다.
여기서 Output은 아직 Mask가 아니다. logit으로 출력되므로, 출력값은 -3.2,0.4,2.8,-0.7과 같이 음수/양수가 혼재되어있을 것이다. 이걸 확인해보자.
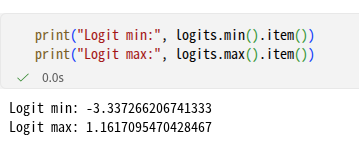
이제 여기에 sigmoid를 적용하면 드디어 확율로써 표현할 수 있게 된다.
sigmoid의 적용과 probabilities
뭐 아직 학습을 한게 아니니 숫자의 크기는 논외로 하자. 코드는 간단하다.
probabilities = torch.sigmoid(logits)
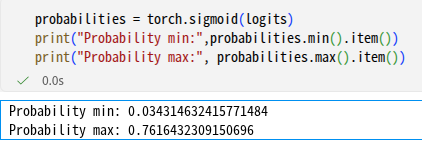
이제 여기에 threshold만 정해 넣으면 최종 Probability sMask를 얻을 수 있다.
pred_masks = (probabilities > 0.5).float()

print("Prediction values:", torch.unique(pred_masks))
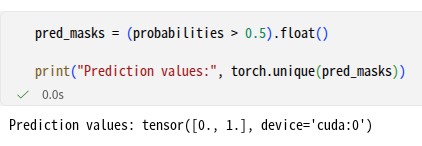
여기까지 해서 네트워크의 구현은 끝났다.
7. Loss / Optimizer 설정
이제 학습을 하기 전, Loss와 Optimizer를 설정하자.
우리는 Binary segmentation이다. 따라서, BCE loss를 쓴다.
loss_fn = nn.BCEWithLogitsLoss()

optimizer = torch.optim.Adam(
    model.parameters(),
    lr=1e-3
)
여기서 주목할건, BCEWithLogitsLoss() 함수를 사용하기 때문에, 네트워크 마지막에 sigmoid를 넣지 않았다. logits 라는 단어가 함수 중간에 떡하고 들어가있으니 sigmoid를 굳이 넣지 말자. 좀전의 것은 전체 흐름 확인을 위해 해본 것일 뿐이다.
loss 함수가 실제로 동작하는지 하나만 넣어 테스트해보자.
images, masks = next(iter(train_loader))

images = images.to(device)
masks = masks.to(device)

logits = model(images)

loss = loss_fn(
    logits,
    masks
)

print("Loss:", loss.item())
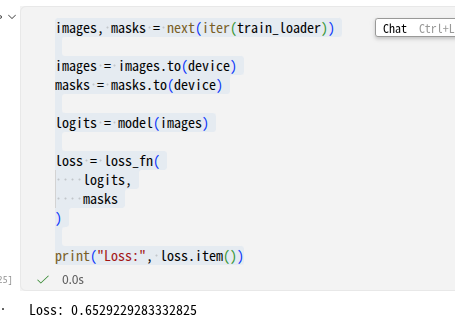
잘 실행되면 Loss 함수까지 잘 연결된 것이다.
8. Training
이제 전체 학습 프레임워크를 구성해보자.
train_one_epoch
먼저 train 함수를 만들자. 보통 1개의 epoch만 training 하는 함수를 별도 만든다. 이는 코드의 가독성을 좋게하고, 역할을 분담하여 실제 loop가 간단하게 정리될 수 있어서 좋다. 특히 train과 validation을 번갈아가면서 수행하는 구조를 깔끔하게 작성할 수 있고, epoch의 숫자를 조절하기도 유용하다.
때에 따라서는 다양한 실험을 하고자 할때, trian_one_epoch_with_oooo 과 같은 별도의 함수를 만들어 사용할 수도 있기 때문에, 굳이 loop안에 섞어 넣지 않는 것이 관습이다.
def train_one_epoch(
    model,
    loader,
    optimizer,
    loss_fn,
    device
):
    model.train()

    total_loss = 0.0

    for images, masks in loader:

        images = images.to(device)
        masks = masks.to(device)

        # -------------------------
        # 1. Gradient 초기화
        # -------------------------
        optimizer.zero_grad()

        # -------------------------
        # 2. Forward
        # -------------------------
        logits = model(images)

        # -------------------------
        # 3. Loss
        # -------------------------
        loss = loss_fn(logits,masks)

        # -------------------------
        # 4. Backpropagation
        # -------------------------
        loss.backward()

        # -------------------------
        # 5. Parameter update
        # -------------------------
        optimizer.step()

        total_loss += loss.item()

    average_loss = (total_loss / len(loader))

    return average_loss
validation and test
평가 함수도 만들어 넣어주자.
def evaluate(
    model,
    loader,
    loss_fn,
    device
):
    model.eval()

    total_loss = 0.0

    with torch.no_grad():

        for images, masks in loader:

            images = images.to(device)
            masks = masks.to(device)

            logits = model(images)

            loss = loss_fn(
                logits,
                masks
            )

            total_loss += loss.item()

    average_loss = (total_loss / len(loader))

    return average_loss
training loop, 학습
이제 학습 루프를 구성해보자. 앞서 함수를 분리한 덕분에, 깔끔하게 정리할 수 있다.
EPOCHS = 10

train_losses = []
test_losses = []

for epoch in range(EPOCHS):

    train_loss = train_one_epoch(
        model,
        train_loader,
        optimizer,
        loss_fn,
        device
    )

    test_loss = evaluate(
        model,
        test_loader,
        loss_fn,
        device
    )

    train_losses.append(train_loss)
    test_losses.append(test_loss)

    print(
        f"Epoch [{epoch+1}/{EPOCHS}] "
        f"Train Loss: {train_loss:.4f} "
        f"Test Loss: {test_loss:.4f}"
    )
가독성이 좋게 잘 정리되어, train-test 의 과정이 보기 쉽게 정리되었다. 실제 학습을 돌려보면 다음과 같은 출력이 나오는걸 확인할 수 있다.
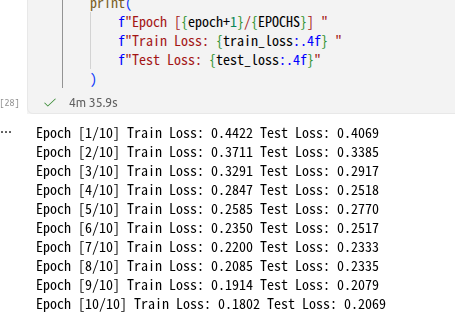
아직은 loss가 좀 크다.
9. 시각화와 IoU/Dice 성능 평가
이제 학습이 어떻게 진행되었는지 눈으로 시각화를 좀 해보자.
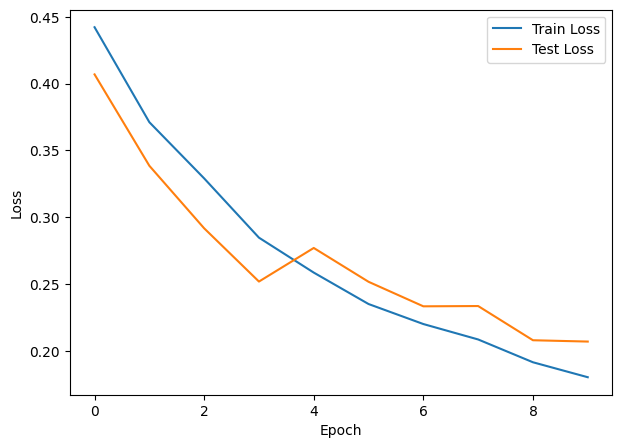
loss 시각화
앞서서 loss값을 list로 저장했기 때문에 그래프를 그릴 수 있다.
plt.figure(figsize=(7, 5))

plt.plot(
    train_losses,
    label="Train Loss"
)

plt.plot(
    test_losses,
    label="Test Loss"
)

plt.xlabel("Epoch")
plt.ylabel("Loss")
plt.legend()

plt.show()
이런거 잘 해놓으면 나중에 보고서/논문 쓸때 좋다.
prediction 시각화
Mask가 어떻게 나왔는지 한번 시각화해보자. threshold는 0.5 로 되어있단걸 상기하자.
model.eval()

image, true_mask = test_dataset[0]

input_tensor = (
    image.unsqueeze(0)
    .to(device)
)

with torch.no_grad():

    logits = model(input_tensor)

    probability = torch.sigmoid(logits)

    pred_mask = (
        probability > 0.5
    ).float()


# CPU로 이동
pred_mask = (
    pred_mask
    .squeeze()
    .cpu()
)

true_mask = true_mask.squeeze()


fig, axes = plt.subplots(
    1,
    3,
    figsize=(15, 5)
)

# Input
axes[0].imshow(
    image.permute(1, 2, 0)
)
axes[0].set_title("Input Image")
axes[0].axis("off")

# Ground Truth
axes[1].imshow(
    true_mask,
    cmap="gray"
)
axes[1].set_title("Ground Truth")
axes[1].axis("off")

# Prediction
axes[2].imshow(
    pred_mask,
    cmap="gray"
)
axes[2].set_title("Prediction")
axes[2].axis("off")

plt.show()
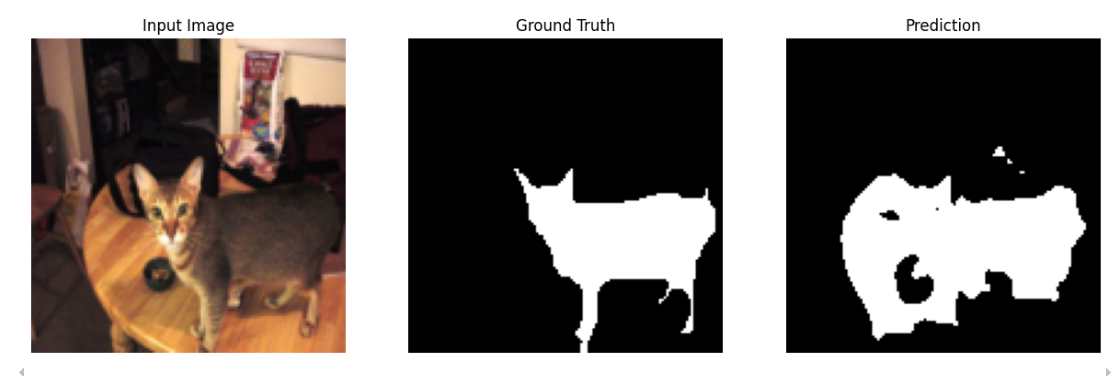
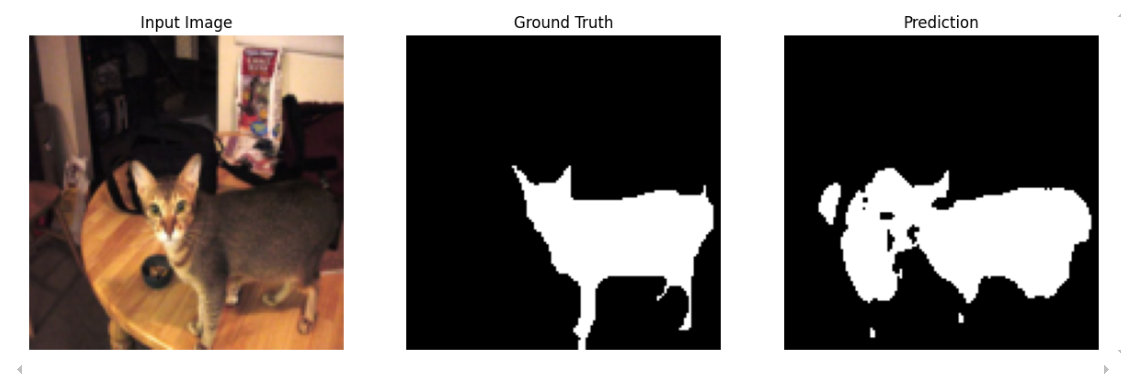
생각보다 결과가 좋지 않다.
IoU와 Dice 성능지표
Day 1에서 언급했듯이, segmentation에서는 accuracy는 사용하지 않고 IoU와 Dice를 지표로 사용한다고 했다.
그걸 측정하는 함수를 다음과 같이 선언해보자.
def calculate_iou_and_dice(
    logits,
    masks,
    threshold=0.5,
    eps=1e-7
):

    probabilities = torch.sigmoid(logits)

    predictions = (
        probabilities > threshold
    ).float()

    # Batch별 계산
    dims = (1, 2, 3)

    intersection = (
        predictions * masks
    ).sum(dim=dims)

    union = (
        predictions + masks
        - predictions * masks
    ).sum(dim=dims)

    iou = (
        intersection + eps
    ) / (
        union + eps
    )

    dice = (
        2 * intersection + eps
    ) / (
        predictions.sum(dim=dims)
        + masks.sum(dim=dims)
        + eps
    )

    return (
        iou.mean().item(),
        dice.mean().item()
    )
그리고 이 함수를 이용해서 Test 데이터를 통해 성능을 확인해본다.
model.eval()

total_iou = 0.0
total_dice = 0.0

num_batches = 0

with torch.no_grad():

    for images, masks in test_loader:

        images = images.to(device)
        masks = masks.to(device)

        logits = model(images)

        iou, dice = (
            calculate_iou_and_dice(
                logits,
                masks
            )
        )

        total_iou += iou
        total_dice += dice

        num_batches += 1


mean_iou = (
    total_iou / num_batches
)

mean_dice = (
    total_dice / num_batches
)


print(
    f"Mean IoU  : {mean_iou:.4f}"
)

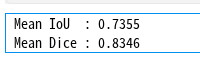
print(
    f"Mean Dice : {mean_dice:.4f}"
)
최종 Traing loop
이제 Traing-Test-Evaluation까지 완전한 루프를 한번 작성해본다.
앞서 작성했던 evaluate()함수를 다음과 같이 수정하자.
def evaluate(
    model,
    loader,
    loss_fn,
    device
):
    model.eval()

    total_loss = 0.0
    total_iou = 0.0
    total_dice = 0.0

    num_batches = 0

    with torch.no_grad():

        for images, masks in loader:

            images = images.to(device)
            masks = masks.to(device)

            # Forward
            logits = model(images)

            # Loss
            loss = loss_fn(
                logits,
                masks
            )

            # IoU / Dice
            iou, dice = calculate_iou_and_dice(
                logits,
                masks
            )

            total_loss += loss.item()
            total_iou += iou
            total_dice += dice

            num_batches += 1

    average_loss = total_loss / num_batches
    average_iou = total_iou / num_batches
    average_dice = total_dice / num_batches

    return (
        average_loss,
        average_iou,
        average_dice
    )
calculate_iou_and_dice() 함수를 train_one_epoch이전으로 옮겨서 선언하는게 원칙이지만, 귀찮다면 좀전의 10 epoch 돌린 traing 이후, evaluation()함수를 다시 선언하고, 모델, loss함수, optimizer를 다시 선언해서 최종 루프를 돌리면 전체 가중치를 초기화 하고 다시 학습한 결과를 얻을 수 잇다.
EPOCHS = 3

train_losses = []
test_losses = []

test_ious = []
test_dices = []

for epoch in range(EPOCHS):

    # -------------------------
    # Training
    # -------------------------
    train_loss = train_one_epoch(
        model,
        train_loader,
        optimizer,
        loss_fn,
        device
    )

    # -------------------------
    # Evaluation
    # -------------------------
    test_loss, test_iou, test_dice = evaluate(
        model,
        test_loader,
        loss_fn,
        device
    )

    # 기록
    train_losses.append(train_loss)
    test_losses.append(test_loss)

    test_ious.append(test_iou)
    test_dices.append(test_dice)

    # 출력
    print(
        f"Epoch [{epoch+1}/{EPOCHS}] | "
        f"Train Loss: {train_loss:.4f} | "
        f"Test Loss: {test_loss:.4f} | "
        f"IoU: {test_iou:.4f} | "
        f"Dice: {test_dice:.4f}"
    )
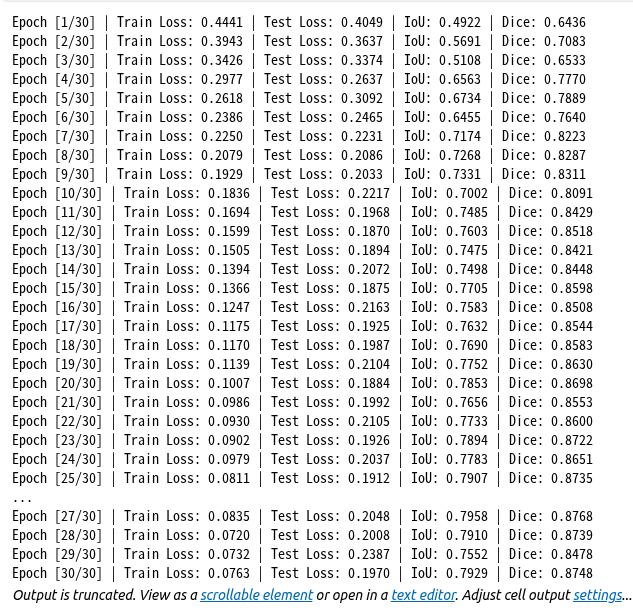
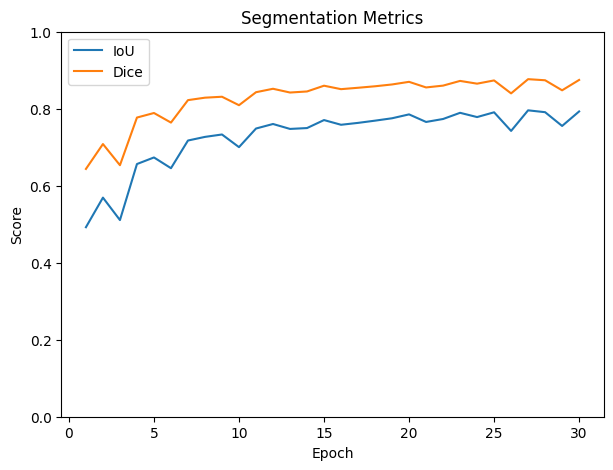
막상 해보면, 10번째 이후부터는 그렇게 개선되는게 없다. 조금씩 나아지기는 한다마는… 예측결과를 시작화 해보면, 그렇게 나아진건가? 하는 생각이 든다.
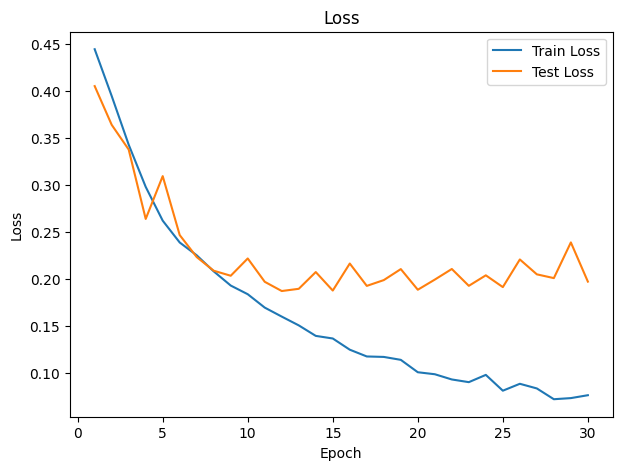
Loss그래프와 평가지표 그래프도 한번 보자.
Daily Quiz
-
Oxford-IIIT Pet의 원본 segmentation trimap을 이번 실습에서 binary segmentation용 mask로 만들 때 사용한 방식은 무엇인가? A. 값 1, 2, 3을 각각 세 개의 출력 채널로 그대로 사용한다. B. 원본 mask의 모든 값을 0과 1 사이의 실수로 정규화한다. C. RGB 세 채널 중 첫 번째 채널만 segmentation mask로 사용한다. D. 원본 mask의 값이 1인 픽셀을 1, 나머지를 0으로 변환한다.
-
Segmentation mask를 resize할 때 bilinear interpolation을 사용하면 클래스에 존재하지 않는 중간 픽셀 값이 만들어질 수 있으므로 이번 실습에서는 nearest-neighbor interpolation을 사용했다. 참 거짓
-
Batch size가 8이고 RGB 입력 이미지를 128×128로 전처리했을 때 U-Net 입력 tensor의 올바른 shape은 무엇인가? A. [8, 3, 128, 128] B. [3, 8, 128, 128] C. [8, 128, 128, 3] D. [8, 1, 128, 128]
-
Encoder feature e4와 upsampling된 decoder feature d4가 각각 [B, 512, 16, 16]일 때 torch.cat([d4, e4], dim=1)의 결과 shape은 무엇인가? A. [B, 512, 32, 32] B. [2B, 512, 16, 16] C. [B, 512, 16, 32] D. [B, 1024, 16, 16]
-
BCEWithLogitsLoss를 사용할 때는 U-Net의 마지막 층에 Sigmoid를 먼저 적용한 probability를 입력해야 한다. 참 거짓
-
이번 binary segmentation 실습에서 U-Net의 출력 logits [B, 1, H, W]에 대해 올바른 설명을 모두 고르시오. A. Sigmoid를 적용하면 각 픽셀 값을 0과 1 사이의 probability로 변환할 수 있다. B. 학습되지 않은 logits도 이미 Ground Truth와 동일한 의미의 binary mask이다. C. 각 픽셀의 logit은 음수나 양수가 될 수 있다. D. 0.5 threshold로 binary mask를 만들려면 일반적으로 logits에 Sigmoid를 적용한 뒤 비교할 수 있다.
-
Ground Truth mask와 U-Net 출력이 모두 [8, 1, 128, 128]인지 forward test에서 확인한 가장 중요한 이유는 무엇인가? A. DataLoader의 shuffle을 비활성화하기 위해 B. U-Net의 parameter 수를 줄이기 위해 C. 픽셀 단위로 prediction과 target을 대응시켜 loss를 계산할 수 있는지 확인하기 위해 D. Sigmoid가 필요 없도록 만들기 위해
-
어떤 segmentation 모델이 대부분의 픽셀을 background로 예측해 높은 Accuracy를 얻었지만 실제 pet 영역은 거의 찾지 못했다. 이 모델의 문제를 더 직접적으로 드러내는 지표는 무엇인가? A. Learning rate B. IoU C. Batch size D. 학습 epoch 번호
-
Prediction과 Ground Truth의 intersection 픽셀 수가 60이고 union 픽셀 수가 100이라면 IoU는 얼마인가? A. 0.75 B. 0.40 C. 0.60 D. 1.00
-
학습된 U-Net을 test dataset에서 평가할 때 model.eval()과 torch.no_grad()를 사용하는 목적을 가장 적절하게 설명한 것은 무엇인가? A. logits를 자동으로 0과 1의 binary mask로 변환하기 위해 B. 모델의 모든 가중치를 랜덤 초기화하기 위해 C. 입력 이미지를 자동으로 128×128로 resize하기 위해 D. 평가 모드로 전환하고 gradient 계산을 생략해 학습용 parameter update 없이 추론하기 위해
댓글남기기