Semantic Segmentation, U-Net Day 4
들어가면서.
원래 day 4에서는 “도면 → Mask → Geometry → 정보 추출 Pipeline”로 이어지는 부분을 하려 했다.
GPT와 짜본 학습계획에선 추출해내는 정보에 공간정보를 Graph로 엮는 부분까지 있었다. 그러나, 실험을 이어가다보니 Mixed UNet 수준에서 멈추고 이제 다른 곳에 집중해봐야 하지 않겠나 싶다.
이거.. 교수님과 상의해봐야 하나.
하여간.
여기까지 U-Net이란 무엇이고, 어떻게 구현하며, 주요 튜닝인자들에 대해 손대 보면서 그 성능이 어떻게 변화함을 확인했다.
어쨌거나. 오늘 정리해볼건 하루짜리는 아니고, 대략 사나흘간의 실험 결과를 정리하는 수준에서 마무리지어볼까 한다.
Day 3까지
뭐 결과가 이러했다.
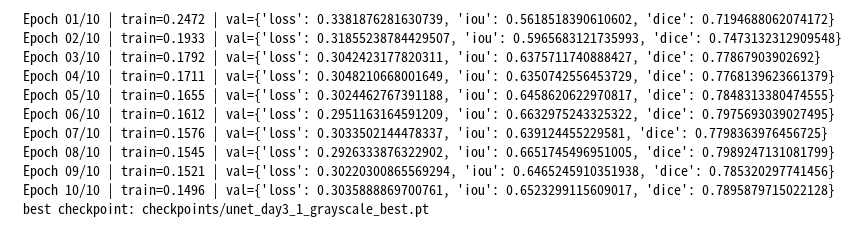
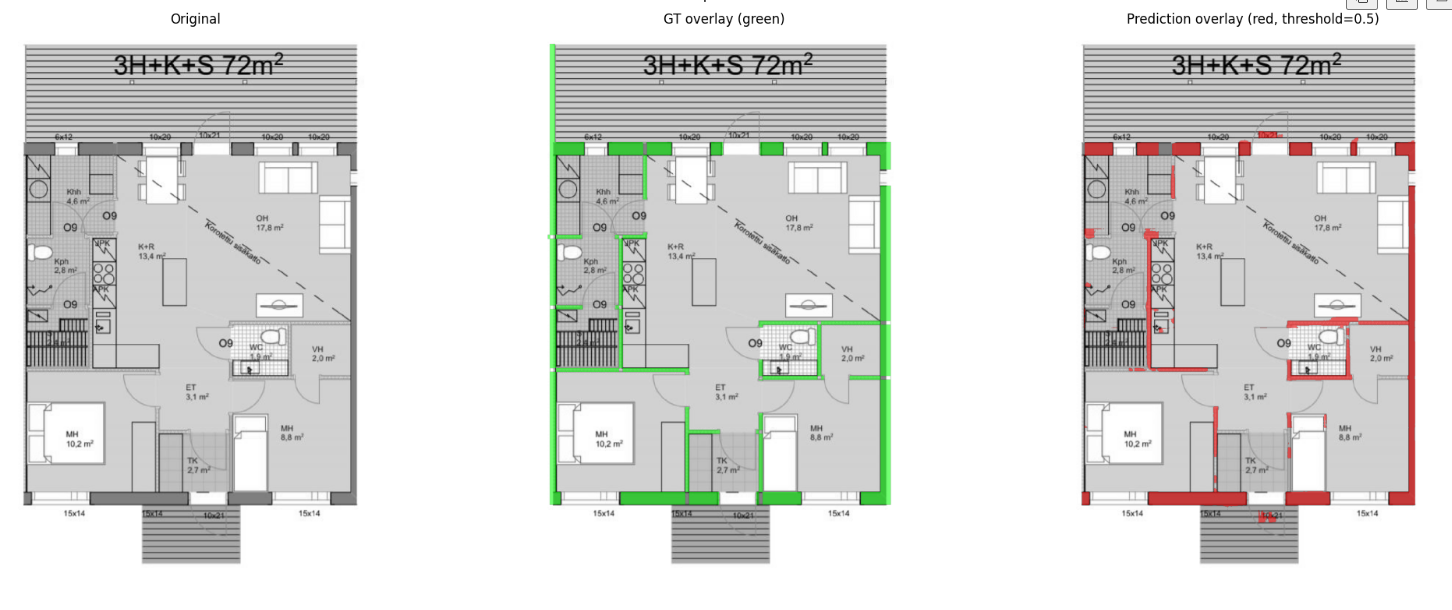
대략적인 IoU 값은 0.6~0.7 사이가 나오고, 애매하게 되는듯 안되는듯 묘했다. U-Net 자체는 2015년에 나왔고, Vanila로 튜닝하는것에는 딱 이만큼의 한계가 있는듯 하다. 이제 Encoder에 Backbone을 붙여보자.
Encoder에 Pretrained Backbone 붙이기
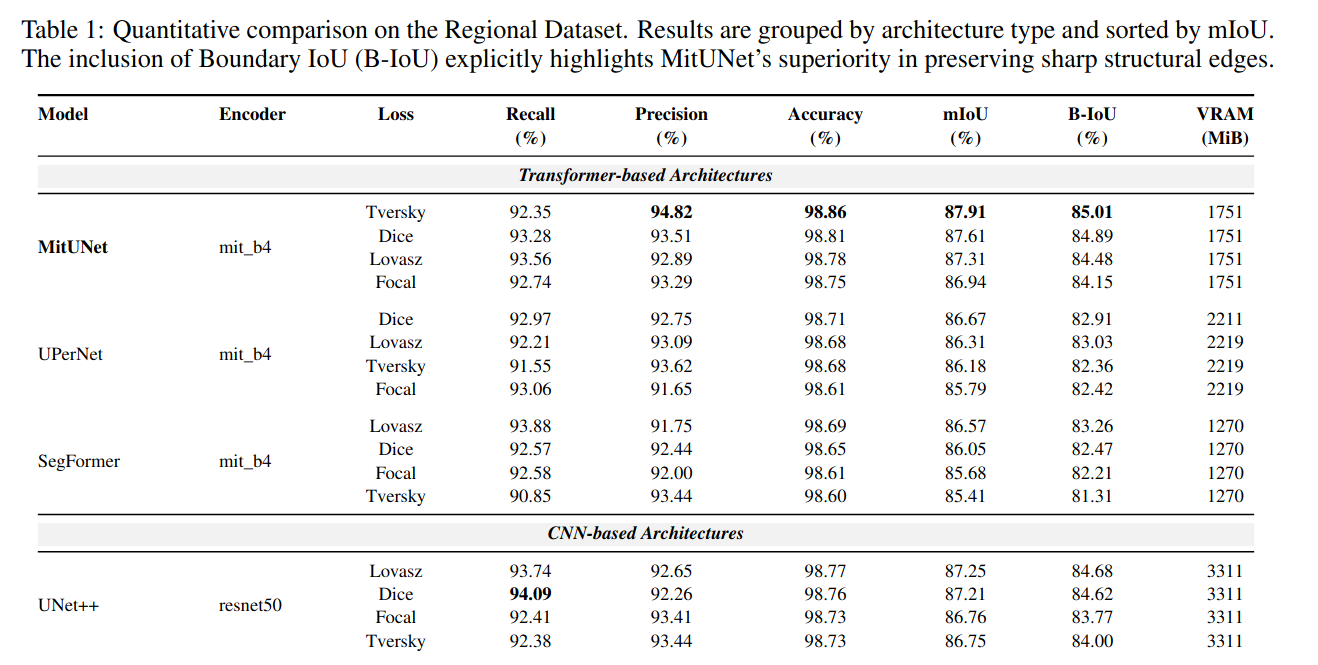
발단은 이 논문이다.
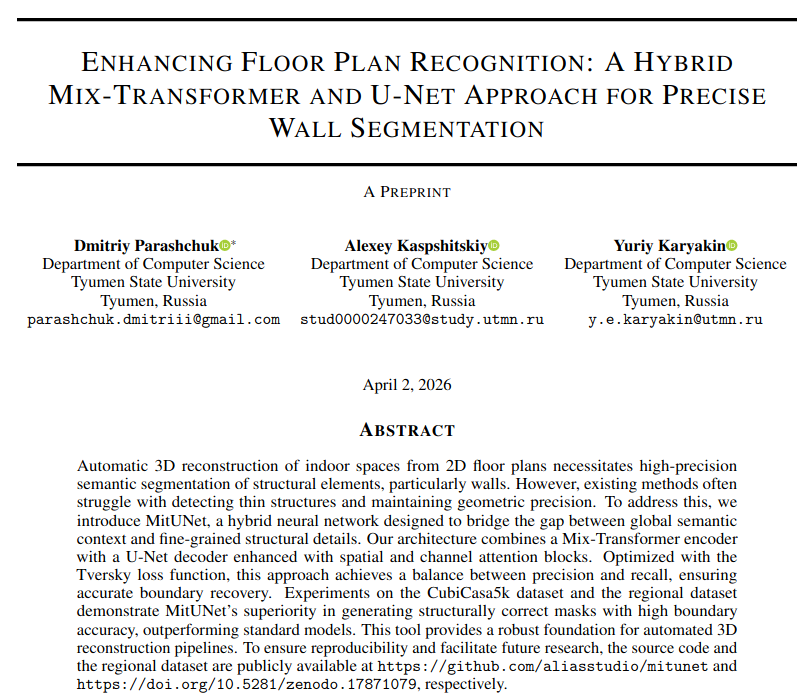
D. Parashchuk, A. Kaspshitskiy, and Y. Karyakin, “Enhancing Floor Plan Recognition: A Hybrid Mix-Transformer and U-Net Approach for Precise Wall Segmentation,” 2025, arXiv. doi: 10.48550/ARXIV.2512.02413. 이 논문에선 mIoU값이 88% 수준으로 내가 한것보다 무려 10%가량 높게 나온다. 그 이유를 이해할 수가 없어서 일단 비슷하게 따라서 재현해보기로 한다. 공식 git
Transfer learning
U-Net의 Encoder 부분에 사전 학습된(Pretrained) 모델을 사용하는 방법은 Pretrained Encoder를 활용한 U-Net 또는 Encoder Transfer Learning이라고 부른다.
기존 U-Net은 Encoder와 Decoder를 모두 처음부터 학습한다. 반면, Pretrained Encoder를 사용하는 U-Net은 ImageNet 등의 대규모 데이터셋에서 학습된 모델을 Encoder로 활용한다.
이때 학습 방식에 따라 두 가지로 구분할 수 있다.
| 구분 | Feature Extraction | Fine-tuning |
|---|---|---|
| Encoder 초기 가중치 | Pretrained | Pretrained |
| Encoder 학습 | 동결(Freeze) | 학습 |
| Decoder 학습 | 학습 | 학습 |
| 학습 비용 | 상대적으로 낮음 | 상대적으로 높음 |
| 도메인 적응 | 제한적 | 상대적으로 유리 |
일반적으로 Fine-tuning 방식이 최종 성능 측면에서 유리할 가능성이 있다.
실험의 설계
모델은 Resnet34와 MiT-B4 를 사용해본다. CNN 계열의 모델과 Transformer 계열의 모델이 얼마나 차이가나는지 같이 비교해가면서 하자.
추가로 참조 논문에서 Input image size를 변경했는데 바뀐 걸 기준으로 확인해보자.
이럴 경우, Encoder 모델 / Loss / Input 이렇게 3인자 8수준 실험이 되겠으나. Input은 512로 고정했으니, 대략 2~3개 케이스정도만 해보면 경향성은 파악할 수 있지 않을까 한다. 따라서 통제요인들을 정리해보면 다음과 같다. 결론을 얻으려는게 아니라 경향만 판단하는 것이니 이렇게 축약버전으로 가본다.
| 실험 | 모델 | 입력 방식 | Input Size |
|---|---|---|---|
| Exp 9-0 | Baseline U-Net | Patch | 512×512 |
| Exp 9-A | ResNet34 U-Net | Patch | 512×512 |
| Exp 9-B | MitUNet | Patch | 512×512 |
| Exp 9-C | MitUNet + Tversky | Patch | 512×512 |
ResNet34 + U-Net
ImageNet에서 사전 학습된 ResNet34를 U-Net의 Encoder로 활용한다.
기존 U-Net과의 차이는 Encoder의 구조 및 초기 가중치다.
ResNet34는 CNN 기반 모델이며, Residual Connection을 이용한다.
수식으로 표현해본다면, Residual Block은 다음과 같이 표현할 수 있다.
\(y = F(x)+x\)
여기서 $F(x)$응 conv 연산으로 학습한 변환이고, $x$는 skip connection을 의미한다.
막상 네트워크를 괴발개발하게 그려보면 요모양인데, 원래의 Unet 과 큰 차이점이 있지는 않다.
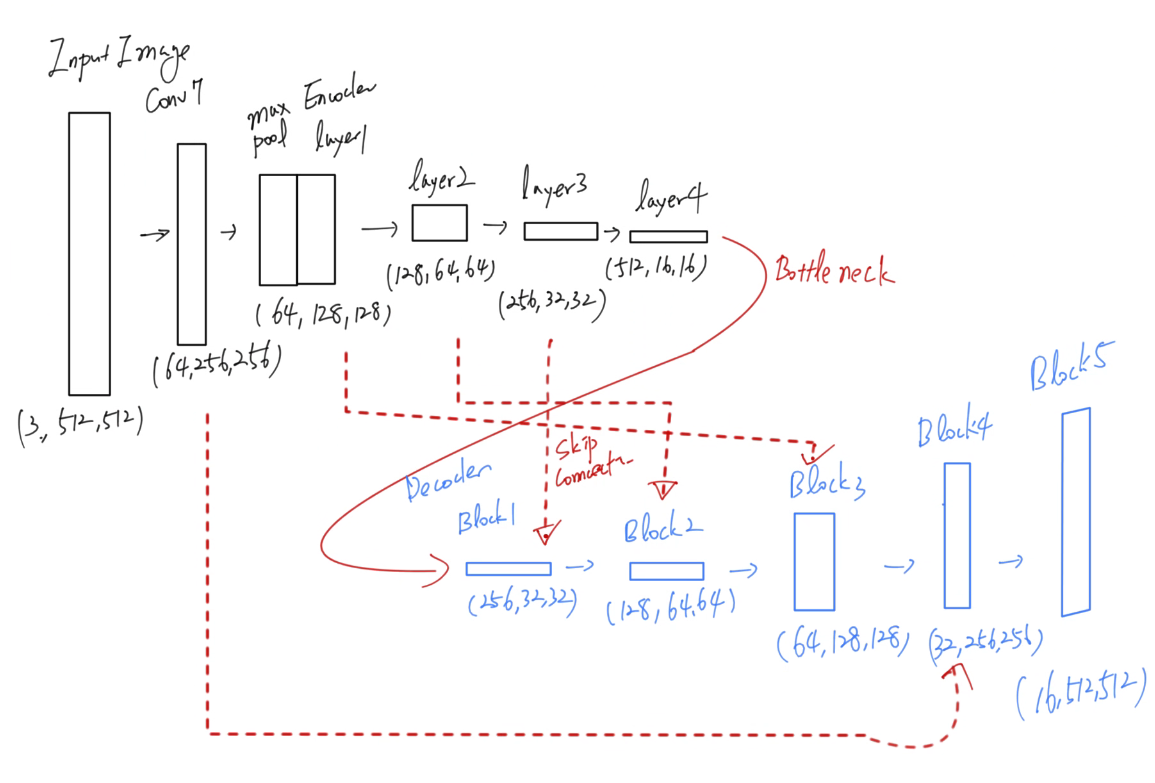
코드로 구현하는건 segmentation_models_pytorch 모듈을 이용해 쉽게 구현할 수 있다.공식문서
상세한 내부 코드는 공식 git에서 확인할 수 있다. https://github.com/qubvel-org/segmentation_models.pytorch/tree/main
모델파일도 같이 링크를 걸어둔다. https://github.com/qubvel-org/segmentation_models.pytorch/blob/main/segmentation_models_pytorch/decoders/unet/model.py
위 그림에 그리진 않았지만, Decoder
import segmentation_models_pytorch as smp

model = smp.Unet(
    encoder_name="resnet34",        # 인코더에 사용할 백본 구조 지정 (예: ResNet34)
    encoder_weights="imagenet",     # ImageNet으로 사전학습된 가중치 사용
    in_channels=3,                  # 입력 이미지의 채널 수 (RGB=3, 흑백=1)
    classes=1,                      # 예측하고자 하는 클래스 개수 (Output 채널 수)
    activation=None                 # 최종 출력의 활성화 함수 (보통 Loss 계산을 위해 None 지정 후 Raw Logit 활용)
)
MiT-B4 + U-Net
이 방법은 참고 논문에 나와있는 방법을 추종하려 한다. 핵심 구조는 Mix-Transformer Encoder + U-Net Decoder + scSE Attention 형태다. Transformer를 사용하는 Unet은 이 형태 이외에도 다양한데, TransUNet (2021)을 시작으로(CNN Encoder + Transformer + U-Net Decoder), Swin-Unet (2021/2022, Swin Transformer Encoder + Bottle Neck + Swin Transformer Decoder), UNETR (2022, Patch Embedding + Vision Transformer + CNN-based Decoder) 의 형태도 있다. 대부분은 의료용에서 많이 사용되는 듯 하다. GPT의 추천은 Swin Transform을 써보라고 하는데, 이건 나중에 여유있을때 한번 해보도록하자.
참고 논문의 MiT-B4에서 MiT는 Mix Vision Transformer의 약자다. 기존 ViT와 달리 다중 해상도의 특징 맵을 생성하는 Hierarchical Transformer다. 논문의 MiT-B4 출력 구조는 다음과 같다.
| Stage | 해상도 | 출력 채널 |
|---|---|---|
| Stage 1 | H/4 × W/4 | 64 |
| Stage 2 | H/8 × W/8 | 128 |
| Stage 3 | H/16 × W/16 | 320 |
| Stage 4 | H/32 × W/32 | 512 |
이 외에도, Efficient Self-Attention, Mix-FFN 라는 용어가 등장하는데 MiT 의 기본적인 구조 특성이다.
Decoder의 형태도 논문을 따르면 다음과 같이 설계된다.
| Decoder | Output Channel | 주요 연산 |
|---|---|---|
| Decoder 1 | 256 | Upsample + Skip + Conv + scSE |
| Decoder 2 | 128 | Upsample + Skip + Conv + scSE |
| Decoder 3 | 64 | Upsample + Skip + Conv + scSE |
| Decoder 4 | 32 | Upsample + Conv + scSE |
입력 해상도까지 복원하는 마지막 단계는 Encoder Skip Connection이 없는 Upsampling 단계로 구성할 수 있다.
scSE Attention이란 용어가 나오는데, Spatial and Channel Squeeze & Excitation의 약자로, 각 채널의 중요도를 계산하는 Channel Squeeze & Excitation (cSE) 부분과 각 픽셀 위치의 중요도를 계산하는 Spatial Squeeze & Excitation (sSE)를 결합한 구조를 뜻한다.
코드로 보면 다음과 같다.
class SCSE(nn.Module):
    def __init__(self, channels, reduction=16):
        super().__init__()
        reduced = max(channels // reduction, 1)
        self.channel = nn.Sequential(
            nn.AdaptiveAvgPool2d(1), nn.Conv2d(channels, reduced, 1), nn.ReLU(inplace=True),
            nn.Conv2d(reduced, channels, 1), nn.Sigmoid(),
        )
        self.spatial = nn.Sequential(nn.Conv2d(channels, 1, 1), nn.Sigmoid())

    def forward(self, x):
        return x * self.channel(x) + x * self.spatial(x)


class MiTDecoderBlock(nn.Module):
    """업샘플된 decoder feature와 encoder skip을 결합하는 블록.

    Args:
        in_channels: 업샘플 전 decoder feature의 채널 수.
        skip_channels: 같은 해상도의 encoder skip feature 채널 수. skip이 없으면 0.
        out_channels: concat 뒤 두 convolution을 거쳐 만들 decoder feature 채널 수.
    """
    def __init__(self, in_channels, skip_channels, out_channels):
        super().__init__()
        self.skip_channels = skip_channels
        self.conv = nn.Sequential(
            # cat(dim=1) 뒤 입력 채널은 in_channels + skip_channels이다.
            # 예: dec3은 512-channel feature와 320-channel skip을 합쳐 832-channel이 된다.
            nn.Conv2d(in_channels + skip_channels, out_channels, 3, padding=1),
            nn.BatchNorm2d(out_channels), nn.ReLU(inplace=True),
            nn.Conv2d(out_channels, out_channels, 3, padding=1),
            nn.BatchNorm2d(out_channels), nn.ReLU(inplace=True),
        )
        self.attention = SCSE(out_channels)

    def forward(self, x, target_size, skip=None):
        # skip과 공간 크기를 정확히 맞춘 뒤 bilinear interpolation으로 업샘플한다.
        x = F.interpolate(x, size=target_size, mode="bilinear", align_corners=False)
        if skip is not None:
            # 공간 크기는 같고 채널 축(dim=1)만 이어 붙인다.
            x = torch.cat((x, skip), dim=1)
        # 두 3×3 convolution으로 채널을 out_channels로 정리한 뒤 scSE attention을 적용한다.
        return self.attention(self.conv(x))


class MiTUNet(nn.Module):
    """ImageNet MiT-B4 encoder + 256/128/64/32 scSE U-Net decoder."""
    def __init__(self, encoder_weights="imagenet"):
        super().__init__()
        self.encoder = smp.encoders.get_encoder("mit_b4", in_channels=3, depth=5, weights=encoder_weights)

        # MiT-B4 encoder feature 채널: features[2:6] = 64 / 128 / 320 / 512.
        # 512×512 입력이면 각 feature의 해상도는 128 / 64 / 32 / 16이다.
        # (in_channels, skip_channels, out_channels) 순서이다.
        self.dec3 = MiTDecoderBlock(512, 320, 256)  # 16→32: 512 + 320 = 832 채널을 256으로 축소
        self.dec2 = MiTDecoderBlock(256, 128, 128)  # 32→64:  256 + 128 = 384 채널을 128로 축소
        self.dec1 = MiTDecoderBlock(128, 64, 64)    # 64→128:  128 + 64 = 192 채널을 64로 축소
        self.dec0 = MiTDecoderBlock(64, 0, 32)      # 128→256: skip 없이 64 채널을 32로 축소
        self.out_conv = nn.Conv2d(32, 1, 1)         # 벽 여부를 나타내는 1-channel logit

    def forward(self, x):
        input_size = x.shape[-2:]  # 마지막 logit을 입력 이미지 크기로 되돌리기 위해 저장
        features = self.encoder(x)

        # SMP MiT encoder의 features[0], features[1]은 입력/1/2 해상도 placeholder이며
        # 실제 MiT-B4 stage feature는 아래 네 개(1/4, 1/8, 1/16, 1/32)다.
        stage1, stage2, stage3, stage4 = features[2], features[3], features[4], features[5]
        # 512 입력 기준: stage1=[B,64,128,128], stage2=[B,128,64,64],
        #               stage3=[B,320,32,32], stage4=[B,512,16,16].

        # 가장 깊은 stage4를 stage3 해상도로 키운 뒤 stage3 skip(320 channels)과 결합한다.
        d3 = self.dec3(stage4, stage3.shape[-2:], stage3)  # [B,256,32,32]
        d2 = self.dec2(d3, stage2.shape[-2:], stage2)      # [B,128,64,64]
        d1 = self.dec1(d2, stage1.shape[-2:], stage1)      # [B,64,128,128]
        # 1/2 해상도 encoder skip은 없으므로 skip_channels=0인 블록으로 한 번 더 복원한다.
        d0 = self.dec0(d1, (stage1.shape[-2] * 2, stage1.shape[-1] * 2))  # [B,32,256,256]
        # 입력 해상도로 한 번 더 업샘플하고 1×1 convolution으로 binary logit을 만든다.
        return self.out_conv(F.interpolate(d0, size=input_size, mode="bilinear", align_corners=False))
실험
앞서 모델들을 반영하여 Base Line 부터 MiT-B4 까지 소행해본 결과를 표로 보면 다음과 같다.
| Experiment | Model | Loss | Best Epoch | Val IoU | Test IoU | Test Dice | Test Precision | Test Recall | Test Boundary IoU | Train Time (s) | Peak GPU Memory (GiB) |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Exp 9-0 | BaselineUNet | BCE + Dice | 8 | 0.677523 | 0.655196 | 0.791684 | 0.790092 | 0.793283 | 0.476076 | 18551.919773 | 3.371519 |
| Exp 9-A | Unet | BCE + Dice | 10 | 0.725200 | 0.722917 | 0.839178 | 0.826945 | 0.851778 | 0.532111 | 7093.616987 | 1.204712 |
| Exp 9-B | MiTUNet | BCE + Dice | 8 | 0.738081 | 0.735419 | 0.847541 | 0.835089 | 0.860369 | 0.548593 | 15158.660743 | 5.613195 |
| Exp 9-C | MiTUNet | Tversky (α=0.6, β=0.4) | 6 | 0.712040 | 0.707653 | 0.828802 | 0.816503 | 0.841476 | 0.518107 | 15228.567890 | 5.616186 |
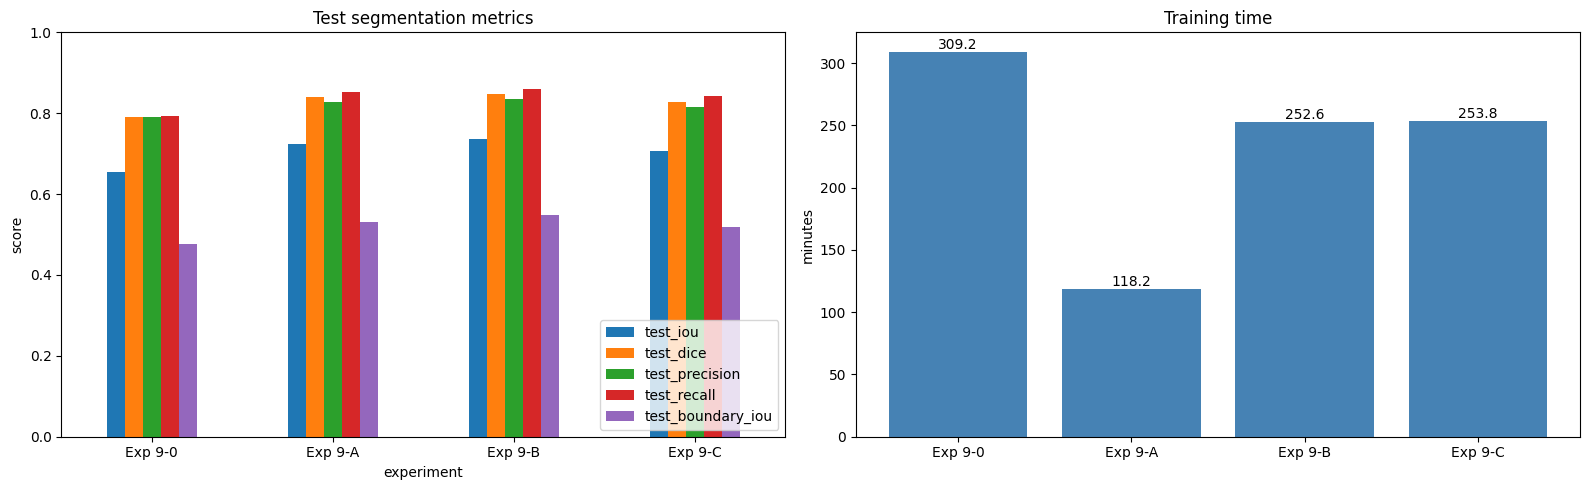
어처구니없게도 MiT-B4 를 쓴 논문의 Transformer 계열보다 ResNet34과 크게 차이가 나지도 않고, Base Line 대비 좋아지긴 했으나, 논문에서 언급한 수준의 성능은 나오지 않는다.
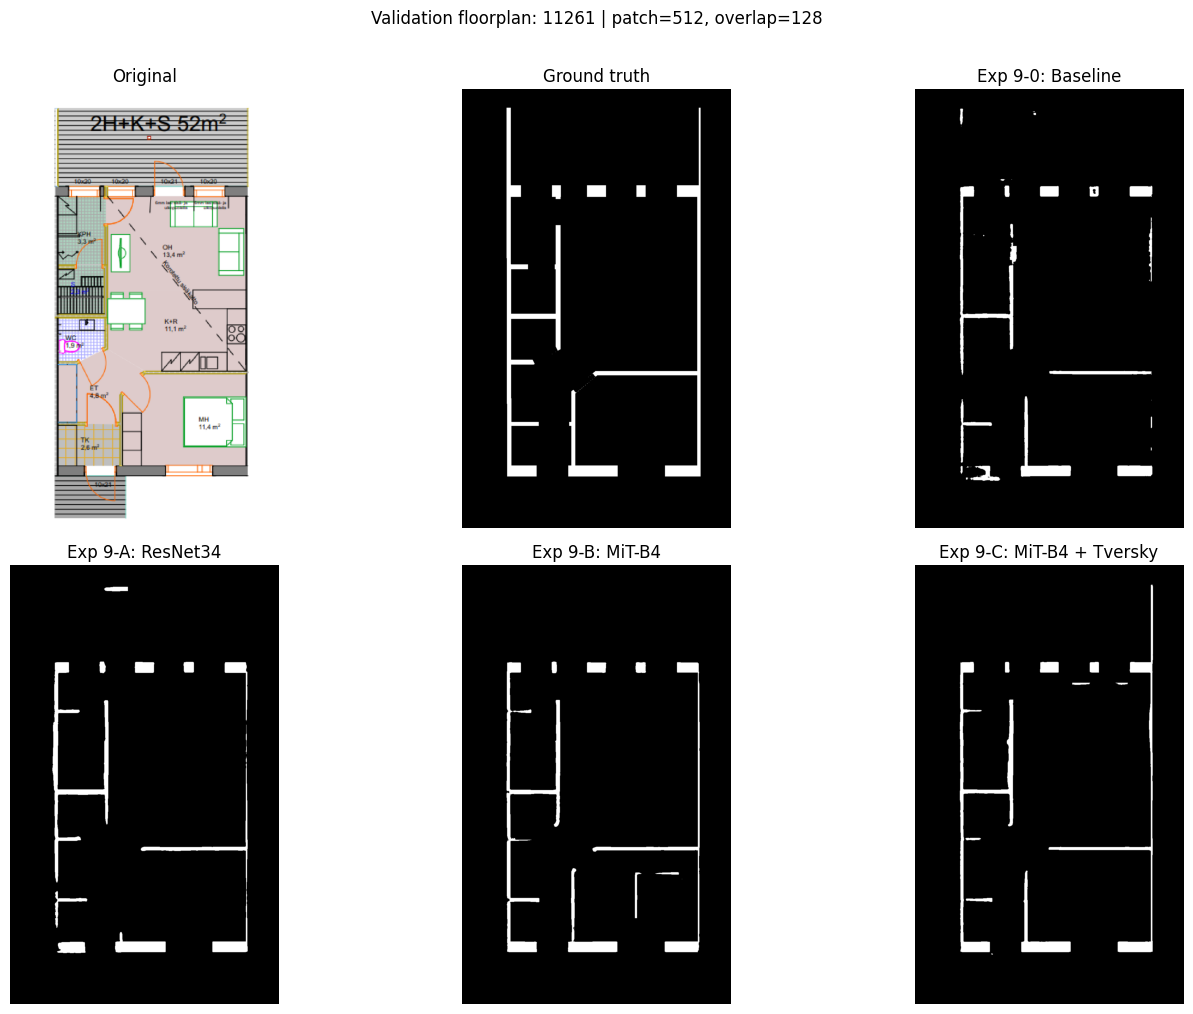
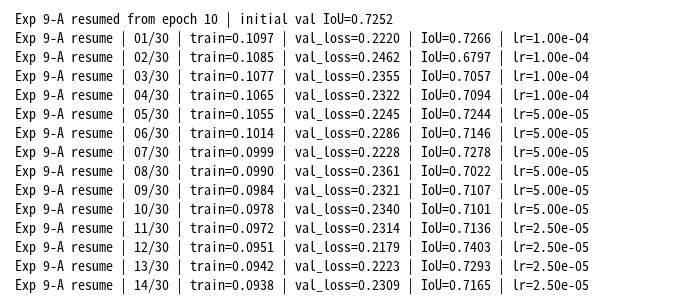
이미지만 놓고봤을때는 차라리 ResNet34가 더 좋은가 싶어서, 혹시나 몰라 ResNet34 에 해당하는 9-A번 실험만 Epoch를 늘여 다시 해보기로 한다. 그리고, 그닥 큰 개선은 보이지 않는다는 한계점을 얻어간다.
오리지널 코드의 실험
그래서 논문에서 공개한 코드를 찾아가, 그걸 기반으로 다시 코드를 작성했다. 그 코드를 보고 나서야 몇가지 차이점을 발견했는데, 논문에선 Patch 방식으로 실험한게 아니라, 전체 이미지를 512x512로 리사이즈 한 이미지를 사용했다는 것을 확인했다. 이는 고해상도보다는 전체 이미지의 맥락이 더 중요하다고 생각할 수 있는 문제다.
그리고 GT Mask 의 구획을 구분하는 과정에서 안쪽으로 마진을 조금 두는 것 같다. 그래서 IoU 값의 차이가 오는 것 아닌가 하는 의심을 해본다. 물론 내가 작업한 GT mask이미지에도 약간씩의 결함은 있어서, 그 부분이 정리가 안된 것도 이유는 되겠다. 그것 수정하면 2~3%정도는 올라주려나..?
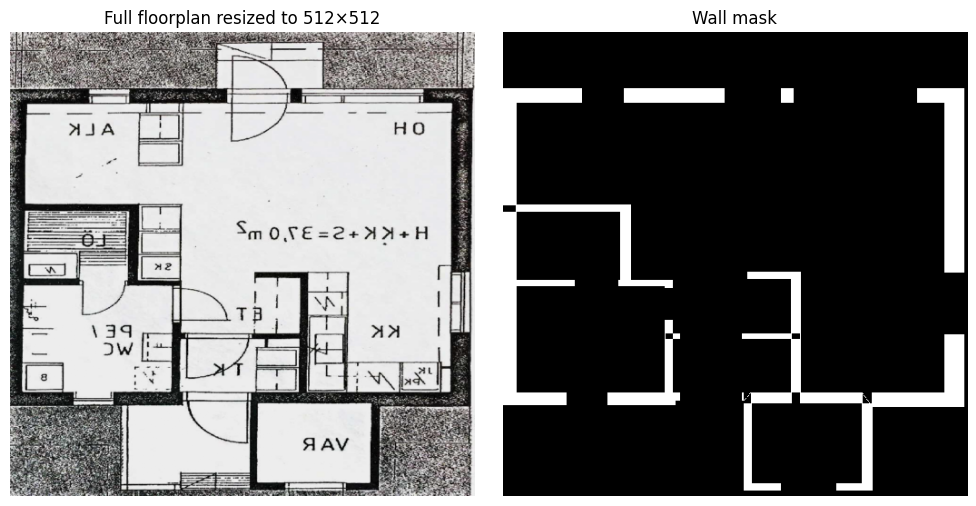
더불어 논문에선 후처리과정까지 있는데, 후처리 과정을 포함하여 IoU 80% 이상의 성능을 뽑은건 아닌가 하는 생각은 든다. 논문에선 후처리 과정이 성능에 기여하는 정도가 분석되어있지 않다.
그래서 원본 논문을 베이스로 내가 얻어낸 성능 최고값은 IoU 0.7685 수준이다.
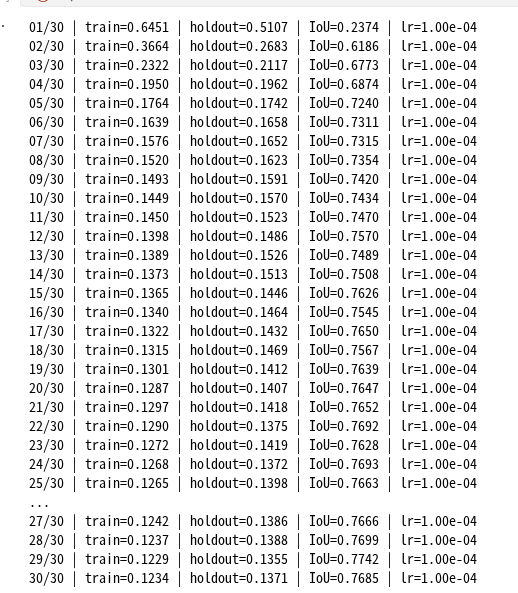
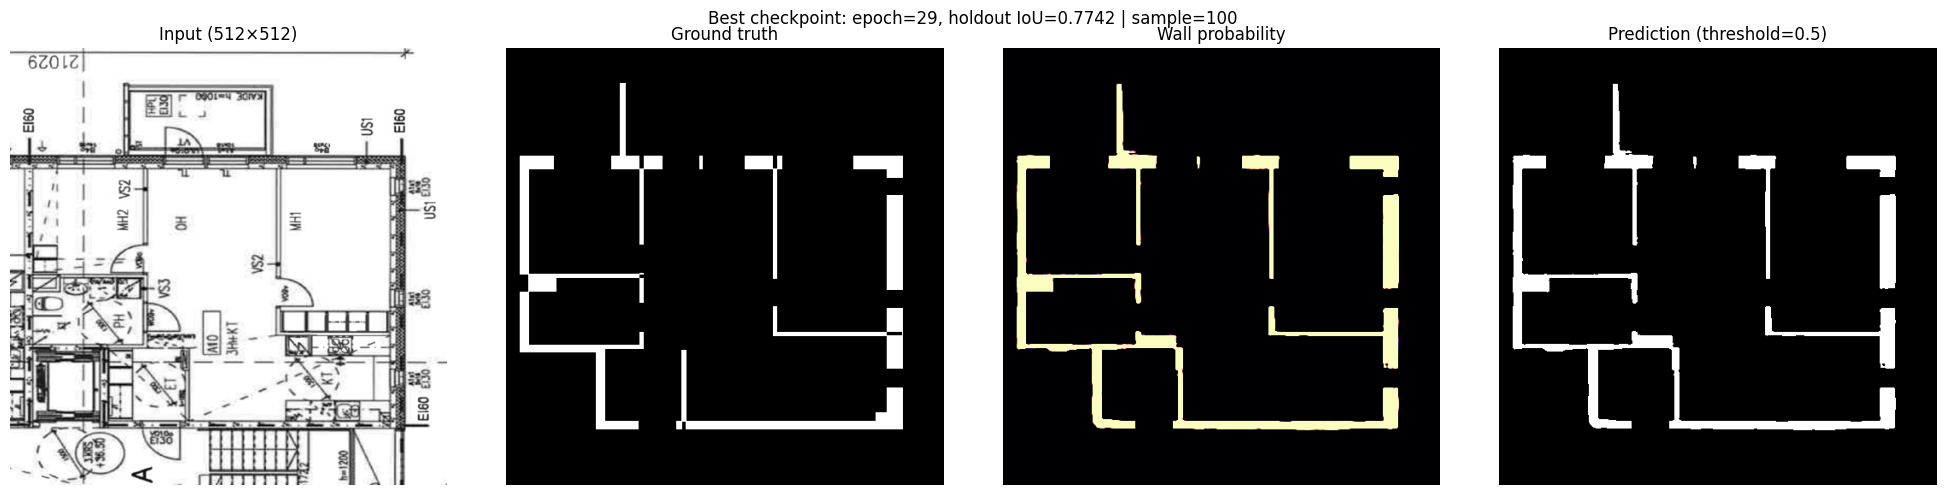
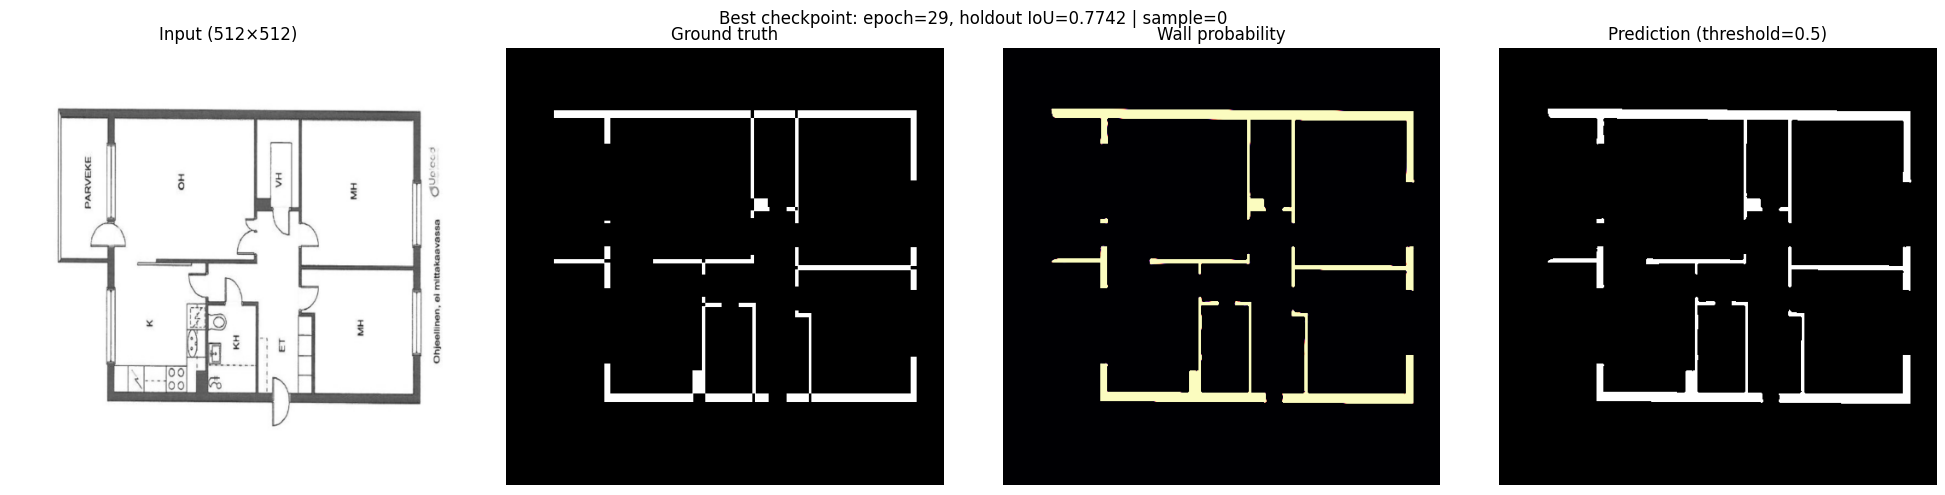
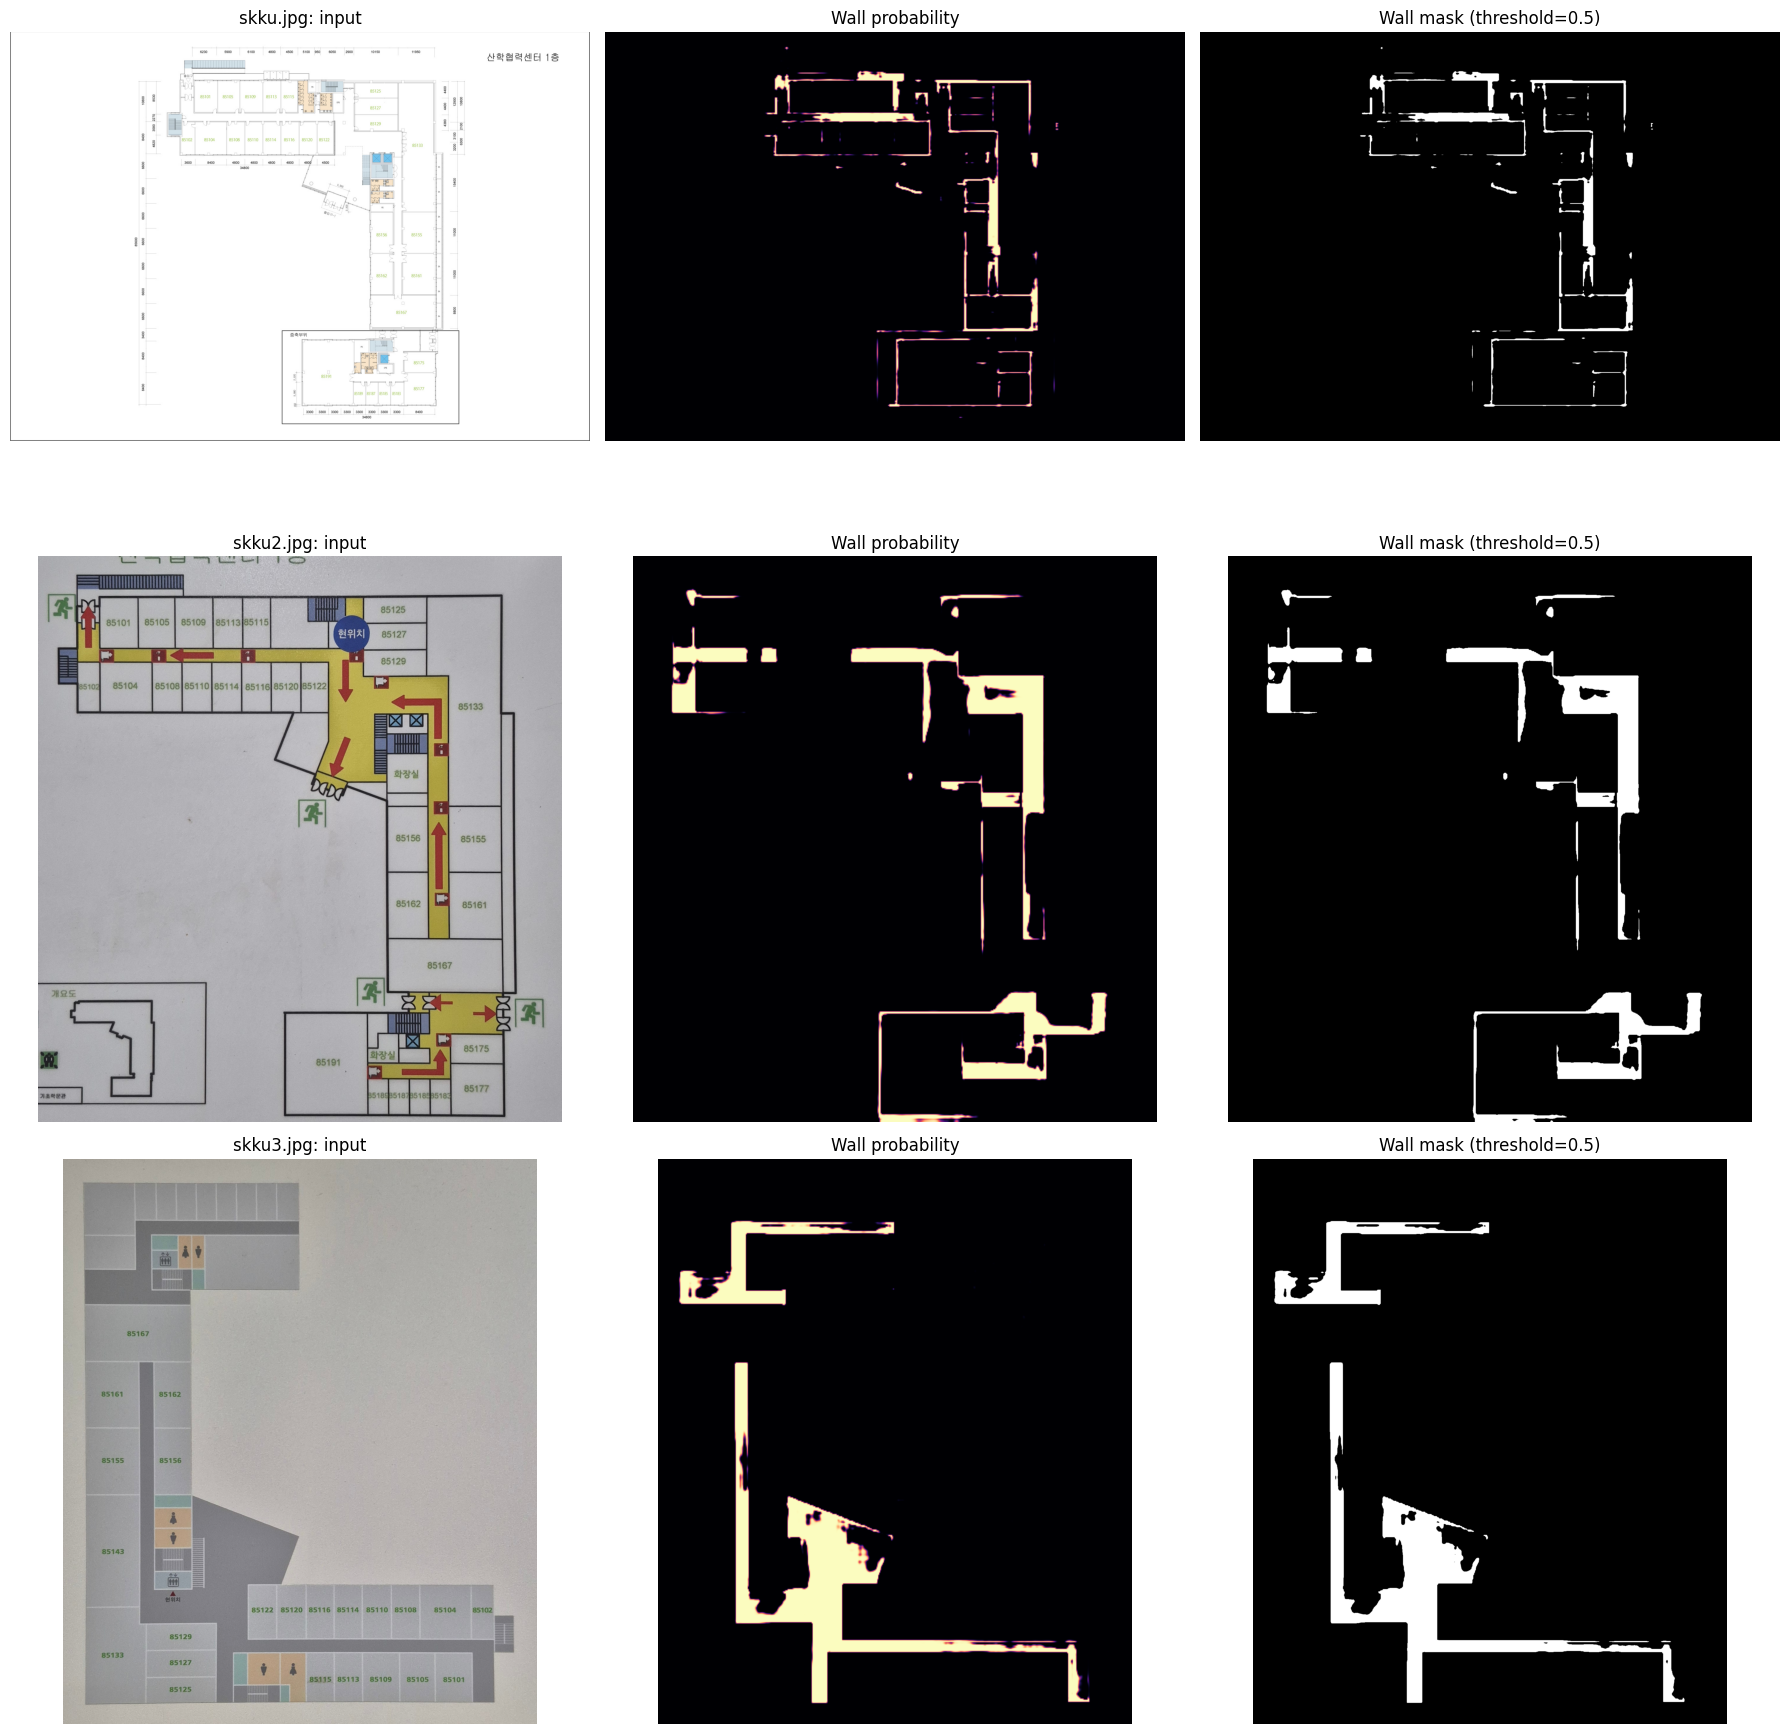
이게, 추가 실험과정에서 알아낸 것인데, Patch 방식을 입력이미지로 사용하게 되면 되려 성능이 떨어짐을 알 수 있었다. 차라리 이미지의 사이즈가 큰 편이 지금의 가장 좋은 성적으로 결론이 남을 확인했다. 이건 좀 의외였달까. 어쨌건, 최종 선택된 가중치를 다시 써서 이번엔 실제 적용해보고자 하는 도면을 넣어보려 한다.

그리고 얻은 결과는 요모양이다. 이제 이걸 어떻게 해결해야 하나 고민하고 덤벼봐야 할 듯 싶다.
이렇게 일단 U-Net에 대한 공부는 일단락해본다.
끗.
댓글남기기