Semantic Segmentation, U-Net Day 3
이미지에서 특정 패턴을 추출해보자.
들어가면서.
지난번엔 Oxford IIIT Pet 데이터셋을 이용해서 Segmentation 프레임워크를 작성해봤고, 그걸 토대로 실험해보면서 성능을 높이기 위해 다음과 같은 항목들을 바꿔봤었다.
- 네트워크 레이어 추가
- Augmentation
- Loss function 수정
- Scheduler, Optimizer 튜닝
- 이미지 사이즈의 조정
- Batch Norm
해서 얻은 결과가 IoU 0.8, Dice 0.87 정도 수준의 결과를 얻었고, 무엇이 중한디를 논해보는 자리였었다.
이번엔 실제 건축도면데이터를 불러와서, 벽을 구분해보는 작업을 수행해보려 한다.
이 4일짜리 튜토리얼을 하는 이유기도 하다.
달라진 데이터에 대해 과연 어떤 부분이 달라지는가를 한번 깊게 들여다보자.
덧붙여서, Oxford IIIT pet 데이터셋을 완료하면서 추가적으로 알게 된게, Pretrained model을 앞부분 encoder에 붙이는 방법의 성능이 더 좋다는 이야기를 한다. 시간의 여유가 더 된다면 U-Net을 응용한 발전된 형태를 한번 시도해보고자 한다.
Day의 목표.
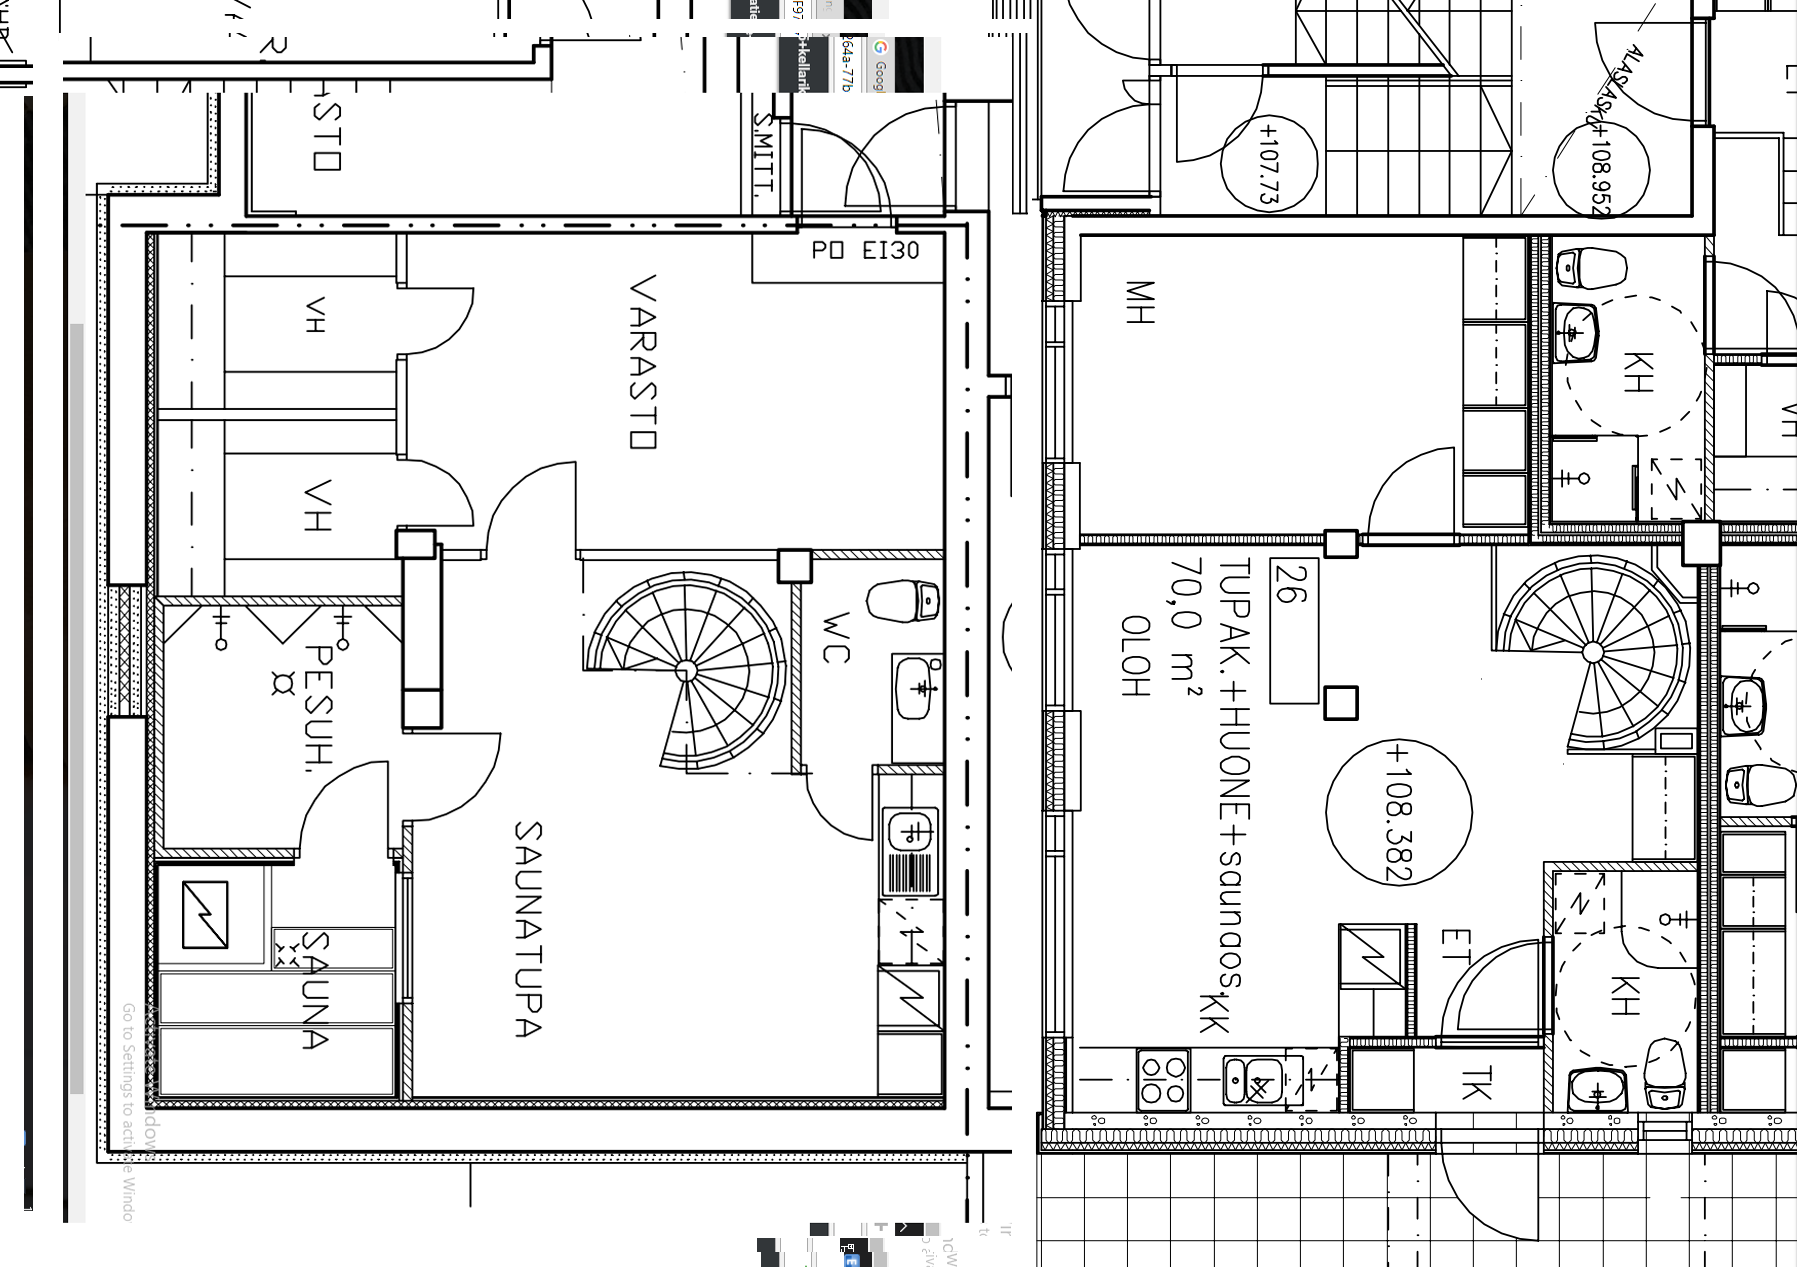
건축도면이란건 벽, 문, 창문, 방, 치수선 등 여러가지 정보들을 담고 있는 자료다. 영어로는 Floorplan이라고 한다. 그리고 친절하게도 CubiCasa5k 라는 데이터셋에선 간단한 건축도면과 함께, 이런 도면의 기호정보에 대한 Class 데이터를 만들어 제공하고 있다. 우리는 이 중에서 Wall 만 구분해보려 한다. 따라서 문제의 형태는 자연스럽게 Binary Segmentation으로 정의할 수 있다.
\[Input Floorplan \to U-Net \to Wall Probability \to Wall Mask\]데이터셋
일단 학습을 진행할 데이터셋은 CubiCasae5K 데이터셋을 사용한다. CubiCasa5k Git
도면의 장수는 5000장정도 된다. 그리고 각 도면별 크기가 좀 크다. 따라서, 앞서 썼던 Oxford IIIT Pet 데이터보다 메모리를 많이 사용할 예정이다.
U-Net
기본적으로 Day2에서 만든 depth 4짜리 네트워크를 재사용한다. BatchNorm 까먹지 말자.
지난번 실험의 설정은 다음과 같다.
- Image Size : 128 × 128
- Loss : BCE + Dice
- Augmentation: O
- Optimizer : AdamW
- Scheduler : ReduceLROnPlateau
- Early Stop : O
- Metric : IoU / Dice
Dataset 전처리
CubiCasa5k 데이터셋은 이전에 받아놓았다. 그 데이터셋의 경로를 지정해보자.
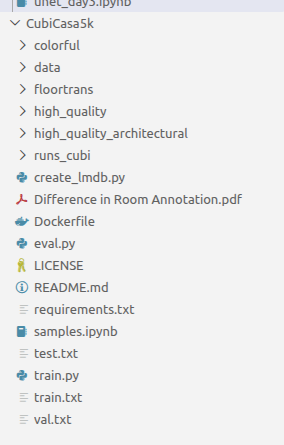
폴더 구조를 보면 colorful, high_quality, high_quality_architectural 이 있는데 이 폴더 안에 각각의 도면과 Mask데이터들이 있다. 이것에 대한 리스트는 test.txt, train.txt, val.txt로 나뉘어져있다.
데이터셋의 경로설정
from pathlib import Path

DATA_DIR = Path(.......)
TRAIN_LIST = DATA_DIR / "train.txt"
VAL_LIST = DATA_DIR / "val.txt"
TEST_LIST = DATA_DIR / "test.txt"

print("Dataset root :", DATA_DIR)
print("Train list   :", TRAIN_LIST)
print("Validation list:", VAL_LIST)
print("Test list    :", TEST_LIST)
데이터셋의 주요 파일
데이터셋 폴더를 탐험하다보면, 몇가지 특징을 찾을 수 있다.
1) 도면은 F1—-.png, F2—-.png, 그리고 그 도면에 대한 annotation은 같은 폴더의 model.svg에 저장되어있다.
2) F1은 1층도면, F2는 2층 도면이지만, 두 파일은 사실 같은 파일이다.
3) F1_original.png는 원본사이즈이고, F1_scaled.png는 원본을 필요한 비율만큼 확대/축소해서 바꾼것이다. 이는 model.svg 파일이 벡터방식으로 저장되어있는데, 이걸 raster(픽셀화)했을때 픽셀좌표계와 딱 안맞을 수 있기 때문에 scale을 조정한 것이다. 혹시나 model.svg와 F—-_scaled.png의 크기가 맞지 않아도 좌표계는 통일되어있으므로 리-스케일링 하면 안된다.
4) train, test, validation에 해당하는 파일들은 txt파일로 되어있다. txt 파일을 열어보면 이런 식이다.
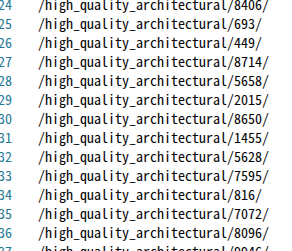
이제 이걸 가지고 image, mask를 만드는 전략을 새워야 한다.
데이터셋 파일 전처리
우선 전처리 전략은 다음과 같다.
1) image는 F1_scaled.png만 써도 된다.. (rasterized되어있으므로) 2) mask 는 F1_scaled의 사이즈만큼의 이미지크기를 가지고, model.svg 파일을 불러와 파싱해서, 원하는 공간에 픽셀을 채워 넣어야 한다. 3) 벽과 문이 중첩되어있다. 문은 제거해내자. 4) 층은 상관없다. F1이미지에 다 있다.
우선 model.svg의 형태를 한번 보자. text editor로 파일을 열어보면 이렇게 보인다.
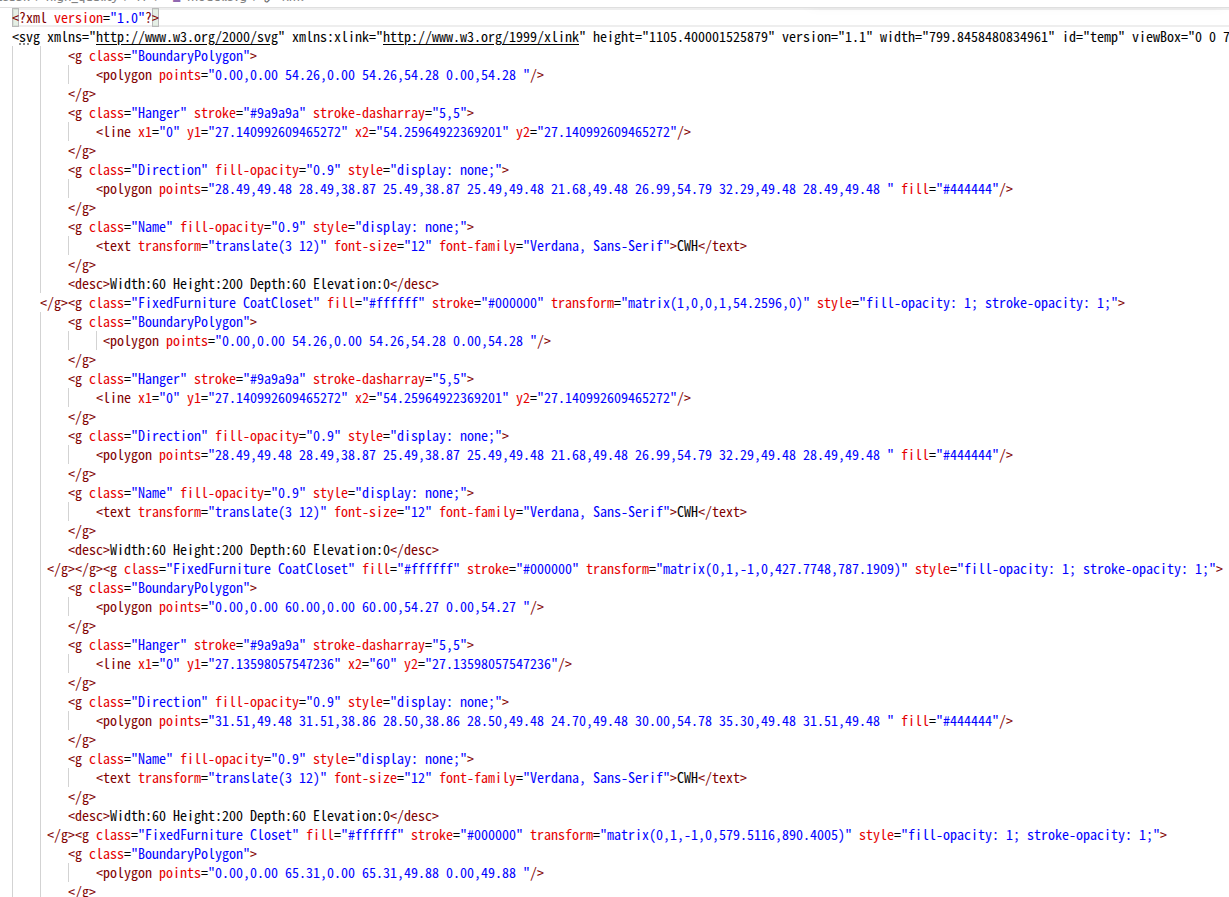
xml포맷으로 되어있고, <g> 라는 태그에 class로 이것이 무엇인지 정의되어있고, 그 위치값이 polygon으로 표현되고 있음을 확인했다.
그러면 이제 그 중 wall이란 것을 찾아 그 polygon을 1로 fill하면 되는 것이다. 그런 방식으로 mask를 만들 수 있다.
이제 필요한 도면 이미지를 Train/Test/Validation에 맞춰 어떻게 핸들링할지 순서를 짜보자.
For [train.txt, test.txt, val.txt]
    Read 텍스트 파일
    File_List = 텍스트파일의 파일 경로들
    Case = 파일 이름이 train.txt면 "train", ㅅ[train.txt!train, test.txt!test, val.txt!val]

    for [File_List]:
        white_out list인지 확인 -> 맞으면 break
        File_List\F1*_scale.png파일을 "data/"+str(Case)에 저장한다. (rename 할까?)
        File_List\model.svg도 같은 경로에 저장한다.
        image 파일의 scale과 동일한 mask.png 파일을 생성하고
        model.svg에서 벽과 관련된 polygon을 불러와 mask.png파일의 해당 좌표 pixel에 1을 넣는다.
        model.svg에서 문과 관련된 polygon을 불러와 mask.png파일의 해당 좌표 pixel에 0을 넣는다.
        검사를 위한 overlay이미지를 overlay.png로 저장한다.
이렇게 하면 전처리 끝인가? 이런 느낌으로 pseudo 코드를 GPT를 통해 만들어봤다.
INPUT:
    CubiCasa5k/
        train.txt
        val.txt
        test.txt
        <category>/<sample_id>/
            F1_scaled.png
            model.svg

OUTPUT:
    data/
        train/<category>/<sample_id>/
            image.png
            mask.png
            overlay.png
        val/<category>/<sample_id>/
            image.png
            mask.png
            overlay.png
        test/<category>/<sample_id>/
            image.png
            mask.png
            overlay.png


FOR each (split_name, split_file) in:
    ("train", train.txt),
    ("val", val.txt),
    ("test", test.txt):

    READ sample-relative paths from split_file

    FOR each relative_sample_path:

        source_dir = CubiCasa5k / relative_sample_path
        output_dir = data / split_name / relative_sample_path
        CREATE output_dir, including parent directories

        image_path = source_dir / "F1_scaled.png"
        svg_path = source_dir / "model.svg"

        LOAD image_path
        PARSE svg_path

        CREATE mask of image size, uint8, initialized to class 0

        FOR each group in SVG:
            EXTRACT every `g id="Wall"` polygon
            RASTERIZE its interior in mask as class 1

        FOR each group in SVG:
            EXTRACT every `g id="Door"` and `g id="Window"` polygon
            RASTERIZE its interior in mask as class 0

        COPY F1_scaled.png to output_dir / "image.png"
        SAVE class-index mask (values 0 or 1) to output_dir / "mask.png"

        CREATE overlay:
            image + semi-transparent wall mask color
        SAVE overlay to output_dir / "overlay.png"
전처리도 매우 중요하긴 한데, 그게 오늘의 메인은 아니니, Pseudo code수준에서 짚고 넘어가자.
이렇게 코드를 작성해서 확인해보면, 도면에서 벽에 해당하는 분이 mask.png로 생성되고, 그걸 원래 도면에 오버레이 해볼 경우 잘 변환됨을 확인할 수 있다.
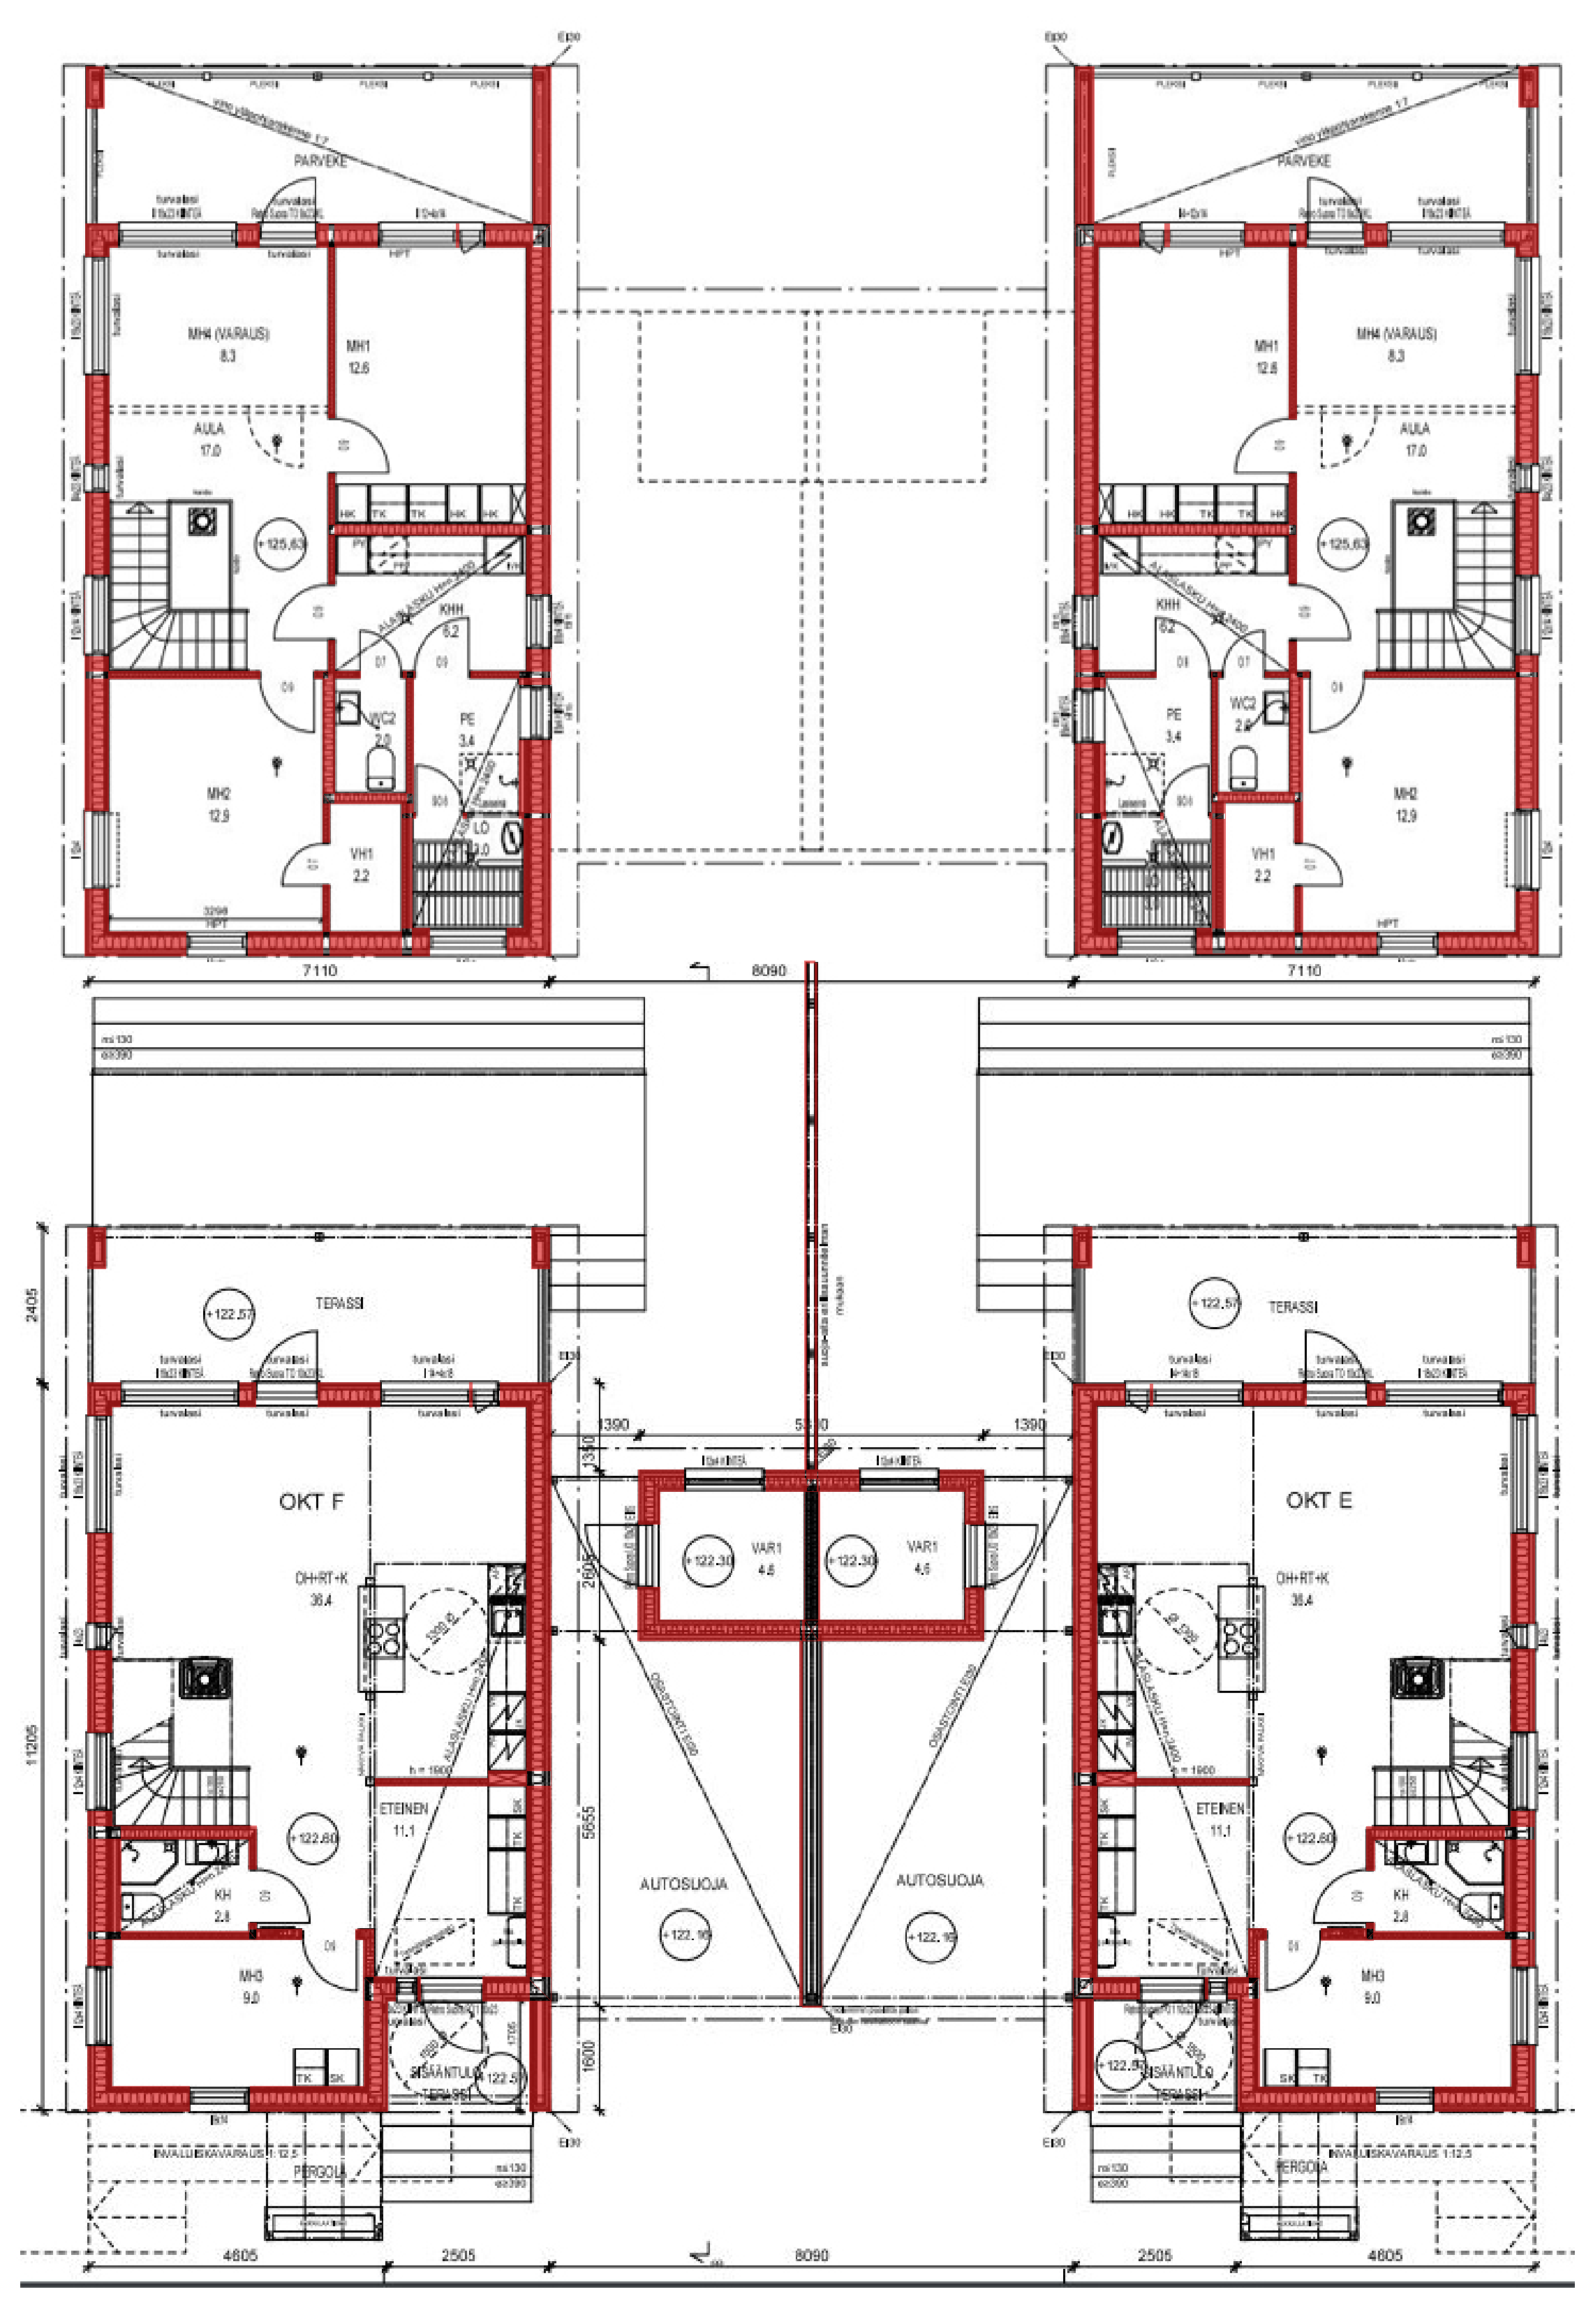
U-Net 구성하기
작업 Agent를 좀 바꿨다.
실제 데이터 핸들링이 많아지다보니, 좀더 원만한 작업을 위해 Codex로 바꿨고, 덕분에 설계기준서를 먼저 작성하고 Codex에 입력하는 방식으로 수행했다.
이제부턴 tutorial이라기보단, 거의 실무에 가까워지는 수준이다.
아래부터 작성된 설계기준서다.
목표
CubiCasa5k distilled 데이터에서 벽 binary segmentation baseline을 학습한다.
CubiCasa5k distilled 은 방금전 전처리를 한 데이터를 말한다.
입력:  image.png
정답:  mask.png (0=배경/문/창, 1=벽)
모델:  Day 2 U-Net
출력:  벽 확률 및 binary mask
데이터 경로와 split
DATA_ROOT = (각자 환경에 따른다.)

train/**/image.png, mask.png
val/**/image.png, mask.png
test/**/image.png, mask.png
- 기존 train/val/test split을 변경하지 않는다.
- overlay.png는 검수용이며 모델 입력에 포함하지 않는다.
- sample별 ID나 카테고리로 다시 섞지 않는다.
Patch의 생성과 원칙
U-Net에 입력되는 이미지 사이즈는 Day 2의 코드 기준으로 128 x 128이다. 그러나 도면데이터는 이보다 훨씬 크다. 여기서 문제가 생긴다.
예를들어 2000x1000 사이즈의 이미지를 128x128로 리사이즈 할 경우, 많은 정보들이 사라질 것이 우려된다. 따라서 이미지를 리사이즈 하는 대신, 128x128로 잘라서 입력하는 방식을 선택한다. 그것이 Patch 개념이다.
추가로 Stride를 설정해서, 만약 패치의 경계에서 오류가 발생하는 것 같다면 Stride를 조절해 중첩을 줄 수 있다. 일종의 Sliding window로 돌아간다.
이걸 위해 데이터셋 이미지를 미리 잘라서 patch로 만들어버릴 경우 U-Net 입력 이미지의 사이즈를 256으로 바꿀때 대응할 수 없므로, Dataloader가 실행되는 시점에 tile을 동적으로 생성하는 방식을 적용한다.
원본 image.png / mask.png
  → 현재 PATCH_SIZE와 STRIDE로 grid 좌표 생성
  → 동일 좌표로 image와 mask crop
  → DataLoader에 전달

기본설정 :
PATCH_SIZE = 128
STRIDE = 128
- STRIDE == PATCH_SIZE이면 모든 영역을 중복 없이 한 번씩 사용한다.
- 이후 PATCH_SIZE = 256으로 바꿔도 전처리 파일을 다시 만들 필요가 없다.
- 벽 경계 끊김 문제가 크면 STRIDE = 64처럼 overlap을 적용한다.
Dataset 구조
일반 map-style Dataset이 patch마다 원본 PNG를 다시 열면 큰 이미지를 반복 디코딩하게 된다. 따라서 IterableDataset 기반으로 구성한다.
FOR each source image-mask pair:
    image와 mask를 한 번만 연다
    grid patch 좌표를 생성한다
    tile 순서를 섞는다
    각 patch를 yield한다
- worker가 여러 개라면 source image 단위로 worker에 분배한다.
- epoch마다 source image 순서와 tile 순서를 섞는다.
- 원본이 patch보다 작거나 마지막 grid 영역이 모자라면:
- image: 흰색 255 padding
- mask: 배경 0 padding
Resize와 interpolation
Patch 학습에서는 원본 좌표계에서 crop하므로 기본적으로 resize를 하지 않는다.
- image와 mask는 항상 같은 crop 좌표와 같은 기하 변환을 사용한다.
- 향후 resize augmentation을 추가하면:- image: bilinear
- mask: nearest-neighbor
Augmentation
baseline augmentation은 mask를 훼손하지 않는 변환만 사용한다.
공통 기하 변환:
- random horizontal flip
- random vertical flip
- random 90° rotation

이미지 전용 변환:
- 약한 brightness / contrast 변화 (선택)
Tile 분포
모든 tile을 사용한다.
대신 epoch마다 아래 통계를 기록한다.
- 전체 tile 수
- 벽을 하나 이상 포함한 tile 수
- 배경-only tile 비율
- sample당 평균 tile 수 큰 도면은 더 많은 tile을 만들어 학습 비중이 커진다. baseline에서는 허용하고, 배경-only tile이 과도하면 이후에만 비율 제한 또는 sample별 tile 수 제한을 추가한다.
Tensor 형식
image: float32, [3, PATCH_SIZE, PATCH_SIZE]
mask : float32, [1, PATCH_SIZE, PATCH_SIZE]
- image: 0~1 tensor 후 Normalize(mean=0.5, std=0.5)
- mask: 값 0/1 그대로 float32
- BCEWithLogitsLoss에 맞춰 mask는 long이 아니라 float32를 사용한다.
DataLoader
BATCH_SIZE = 16       # GPU baseline
NUM_WORKERS = 0       # notebook 안정성 우선
- GPU 메모리가 부족하면 batch size를 8 또는 4로 낮춘다.
- train은 source/tile 순서를 섞는다.
- val/test는 고정 순서로 전체 tile을 순회한다.
모델
Day 2의 U-Net을 그대로 재사용한다.
Input:  RGB patch, [B, 3, H, W]

Encoder:
  DoubleConv(3   → 64)  → MaxPool
  DoubleConv(64  → 128) → MaxPool
  DoubleConv(128 → 256) → MaxPool
  DoubleConv(256 → 512) → MaxPool

Bottleneck:
  DoubleConv(512 → 1024)

Decoder:
  TransposedConv(1024 → 512) + Encoder-4 skip connection → DoubleConv(1024 → 512)
  TransposedConv(512  → 256) + Encoder-3 skip connection → DoubleConv(512  → 256)
  TransposedConv(256  → 128) + Encoder-2 skip connection → DoubleConv(256  → 128)
  TransposedConv(128  → 64)  + Encoder-1 skip connection → DoubleConv(128  → 64)

Output:
  1×1 Conv(64 → 1)
  logits: [B, 1, H, W]
DoubleConv는 다음과 같다.
Conv 3×3 → BatchNorm → ReLU
Conv 3×3 → BatchNorm → ReLU
- 128과 256은 모두 16의 배수이므로 Day 2의 4단계 pooling 구조와 호환된다.
- 모델 출력은 sigmoid 이전 logit이다.
Loss function
loss = 0.5 × BCEWithLogitsLoss + 0.5 × DiceLoss
- BCE는 픽셀별 분류를 담당한다.
- Dice loss는 배경 비율이 큰 벽 mask의 class imbalance를 완화한다.
평가
학습 중에는 validation split으로 모델을 선택하고, test split은 최종 평가에만 사용한다.
probability = sigmoid(logits)
prediction  = probability >= 0.5
계산 항목:
- validation loss
- IoU
- Dice
STRIDE == PATCH_SIZE일 때는 모든 tile의 TP/FP/FN을 누적해 전체 픽셀 기준 IoU/Dice를 계산한다. overlap tile을 사용할 경우에는 동일 위치의 logit을 누적 평균한 뒤, 전체 이미지 단위로 threshold와 metric을 계산한다.
결과 분석
검수용 시각화는 다음을 제공한다.
Input patch | GT mask | Probability | Prediction | Error map
Error map:
- TP: 흰색
- FN: 노랑 — 벽 끊김, 얇은 벽 손실
- FP: 빨강 — 문 주변, 텍스트, 가구선 등 오검출 추가로 validation/test에서 Dice가 낮은 샘플을 우선 표시해 다음을 확인한다.
- 긴 벽의 단절
- 1~2 pixel 벽의 소실
- 문·창 인근의 false positive
- patch 경계에서의 예측 단절
- 128×128 해상도 자체의 한계
실행원칙
실행 원칙
- notebook 생성 직후에는 학습 실행을 기본 비활성화한다.
- DataLoader에서 한 batch를 실제로 꺼내 shape, dtype, mask 값, 시각화를 검증한다.
- 그 다음 128×128 baseline 학습을 시작한다.
(설계기준서 끝.)
요롷게 실행하는데 현제 VRAM 4GB 먹고 있다. 준수하네.
실험 1. Base Line
위의 방향대로 코드를 작성해서 실험해본다. 이제부터는 train한번에 30분가량 걸리기때문에 시간이 오래걸린다.
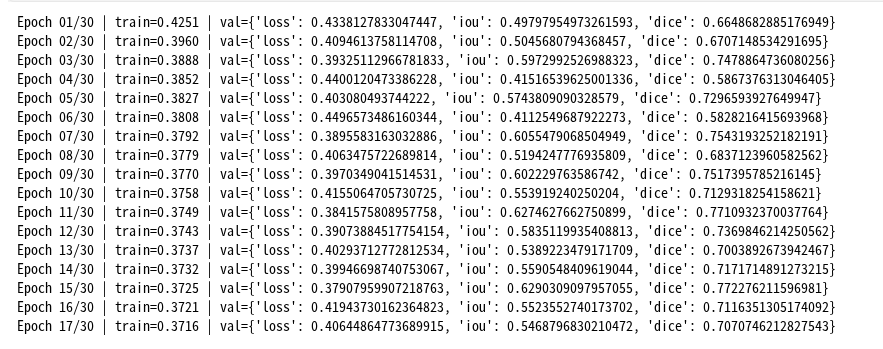
첫 실험의 결과는 생각보다 loss가 줄어들지 않는다는 것.
뭔가 데이터가 너무 많은 것 같다.
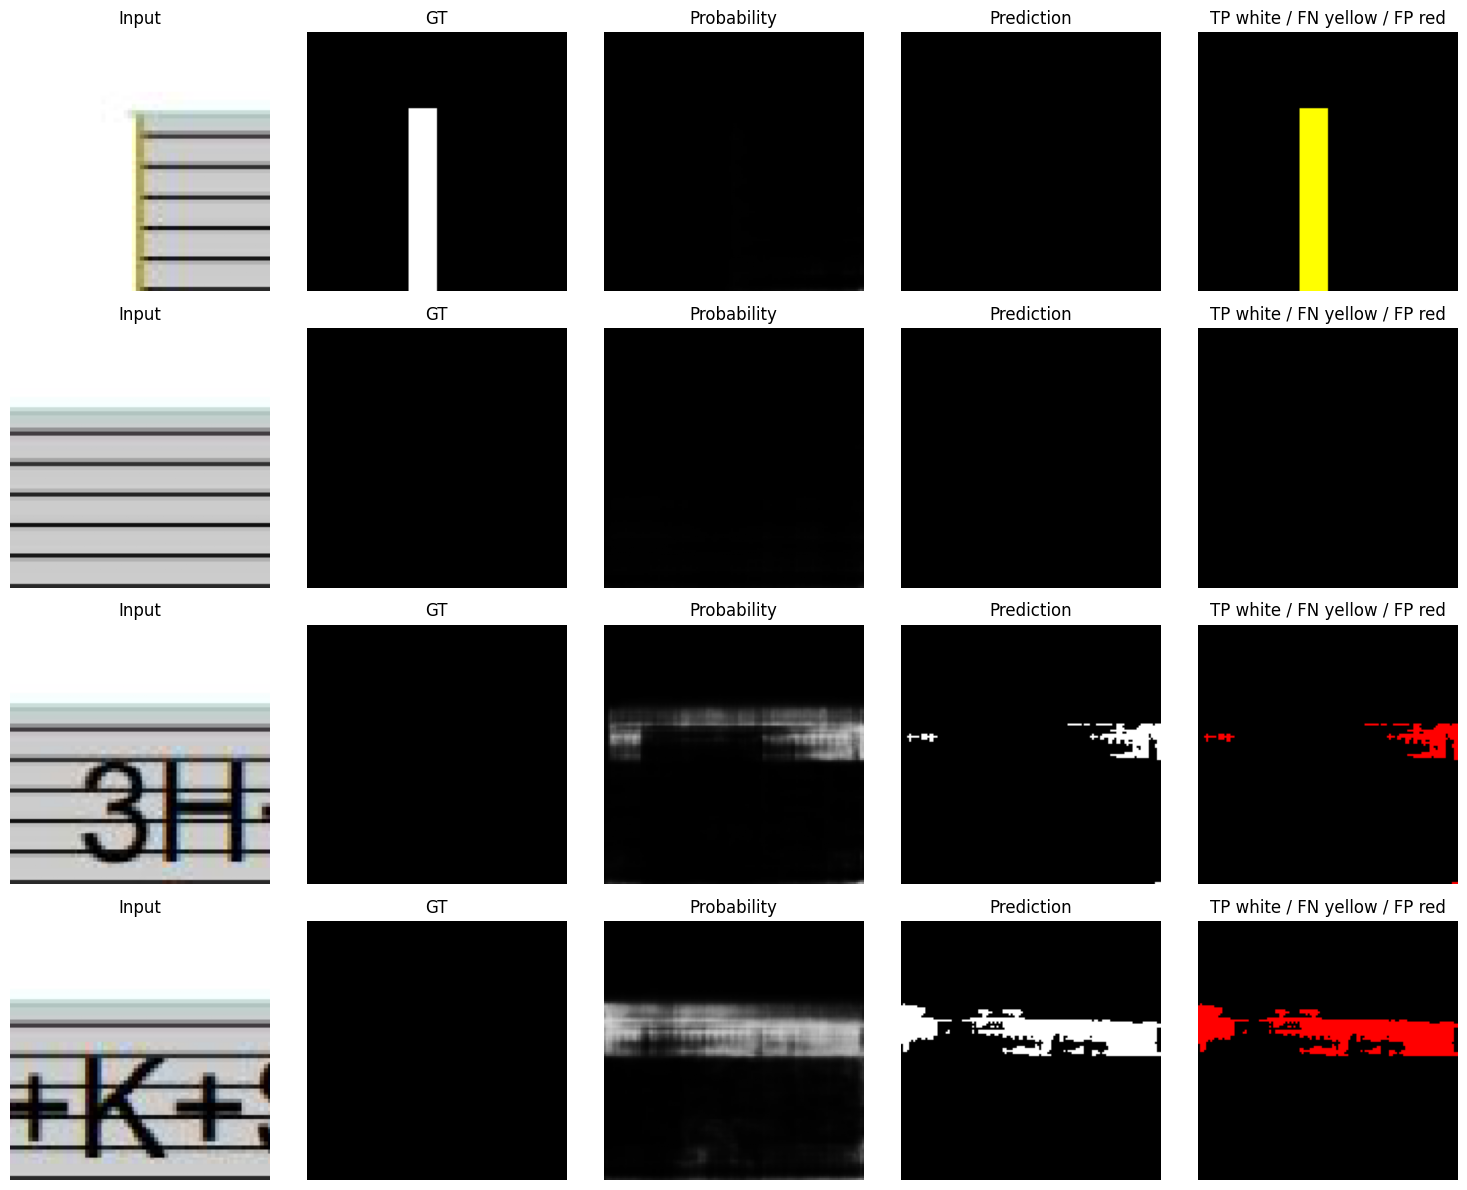
우선 우려되는건 벽이 없는걸 학습해서 과적합이 되는가 대한 우려를 생각해보자.
실험 2. Image size up
뭐….. 벽이 없는 부분은 빼고 수행해본다.
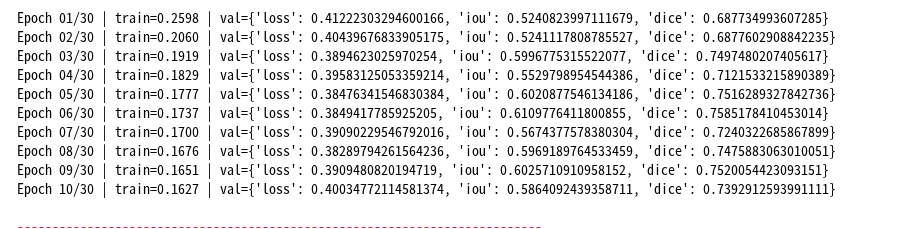
그렇게까지 개선된 효과는 보이지 않는다.
아무래도 패치의 사이즈가 작아 도면이 너무 작게 입력되는것 아닌가를 의심해봐야겠다.
prediction 이미지를 봐도, 벽이 충분히 표현된다고 보긴 어려워서… image 사이즈를 키워서 시도해보자.
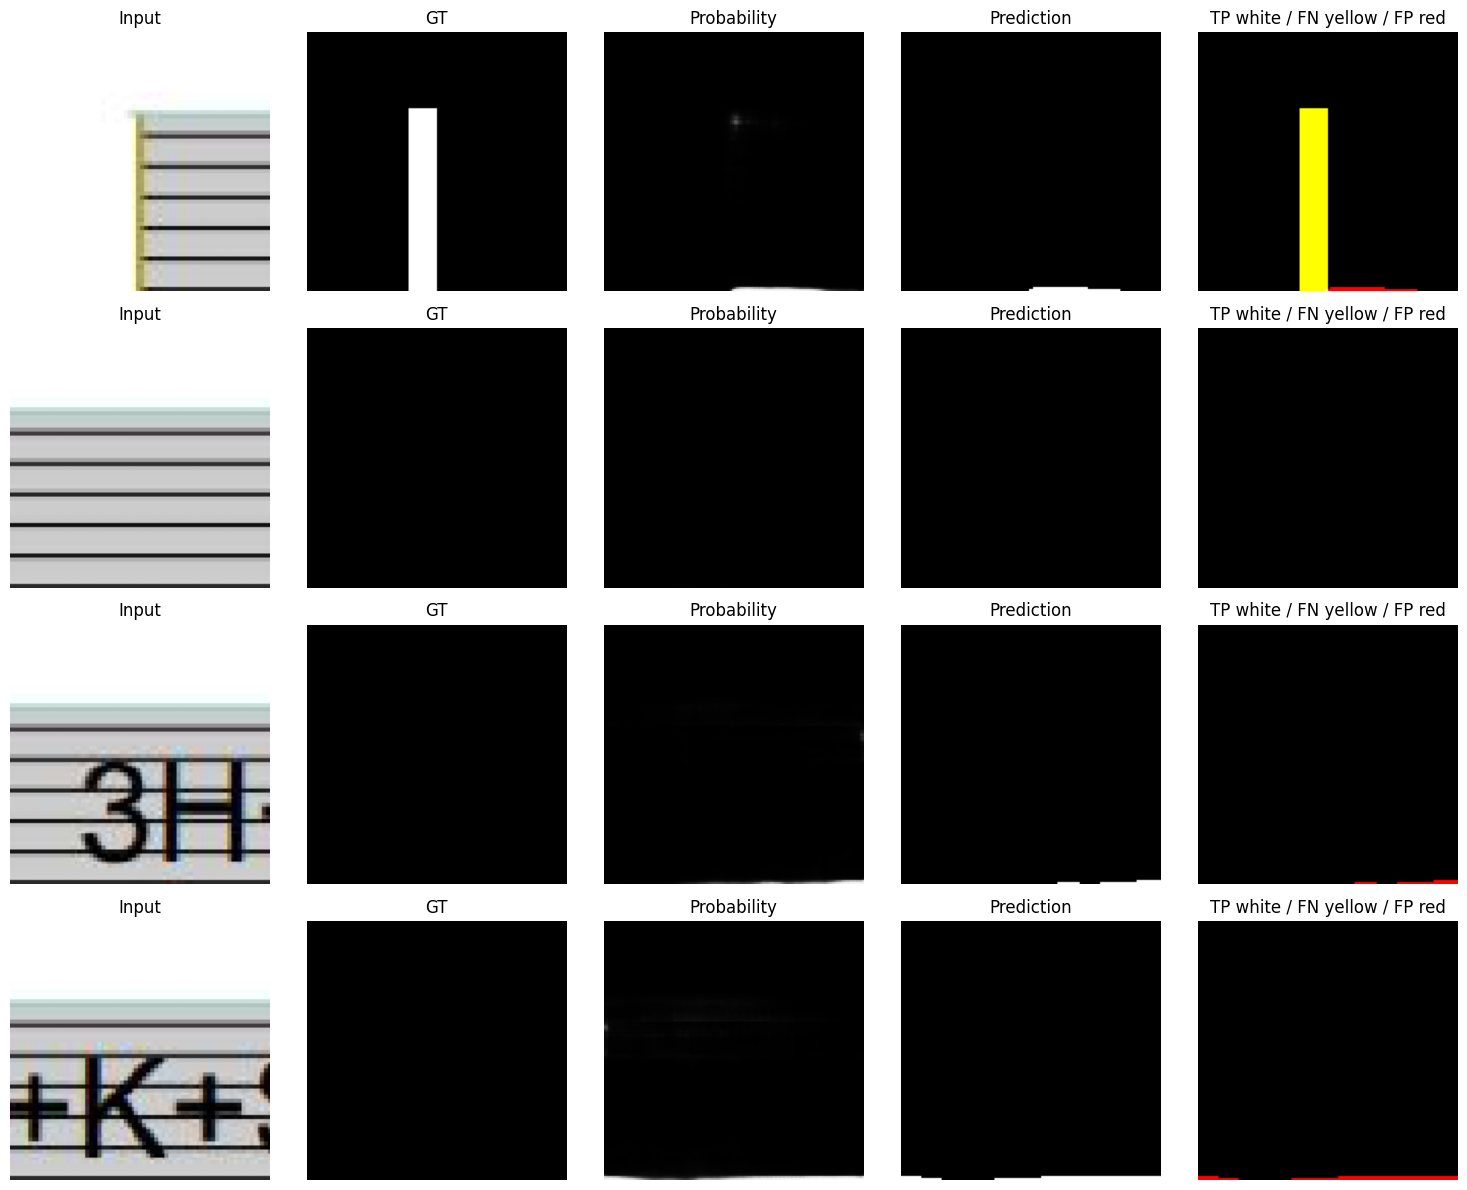
실험 3.
입력 이미지의 크기를 256으로 변경해본다. 자연스럽게 bottle neck 까지 사이즈가 4배씩 커진다.
참조하는 논문의 형태와 일치하는데, 그 논문도 256 사이즈의 입력을 사용한다.
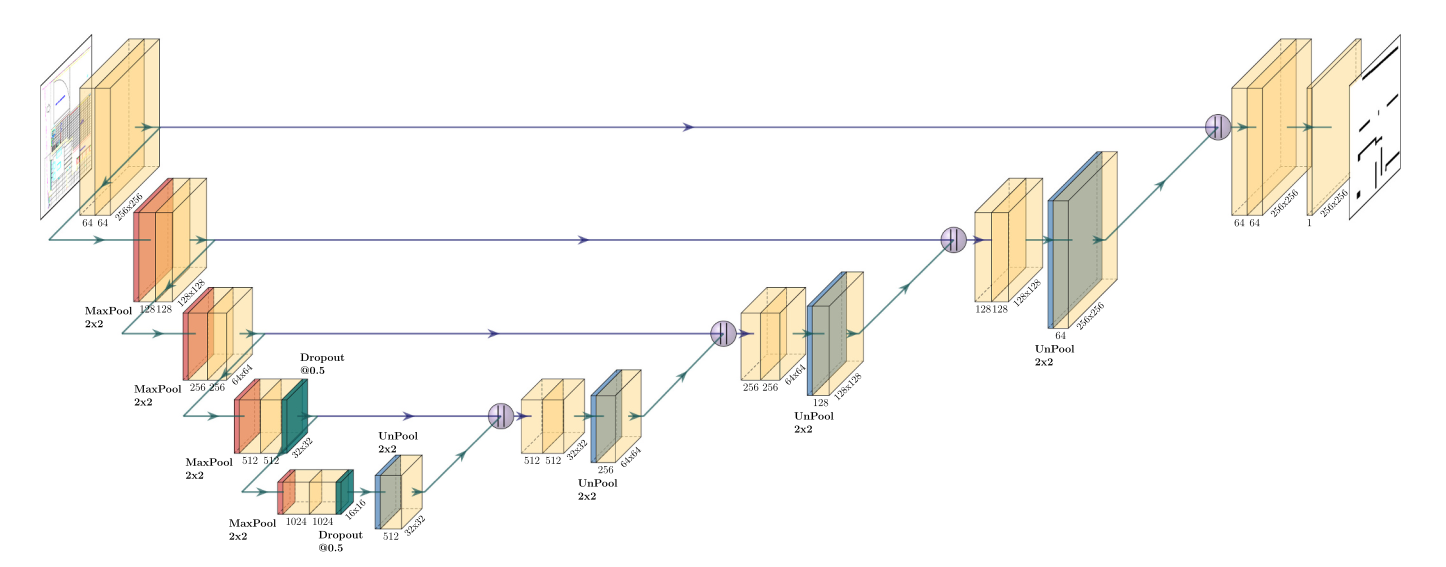
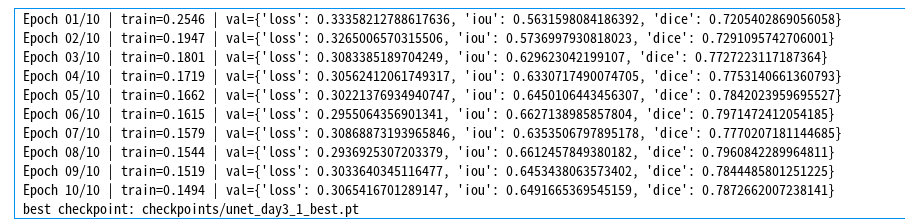
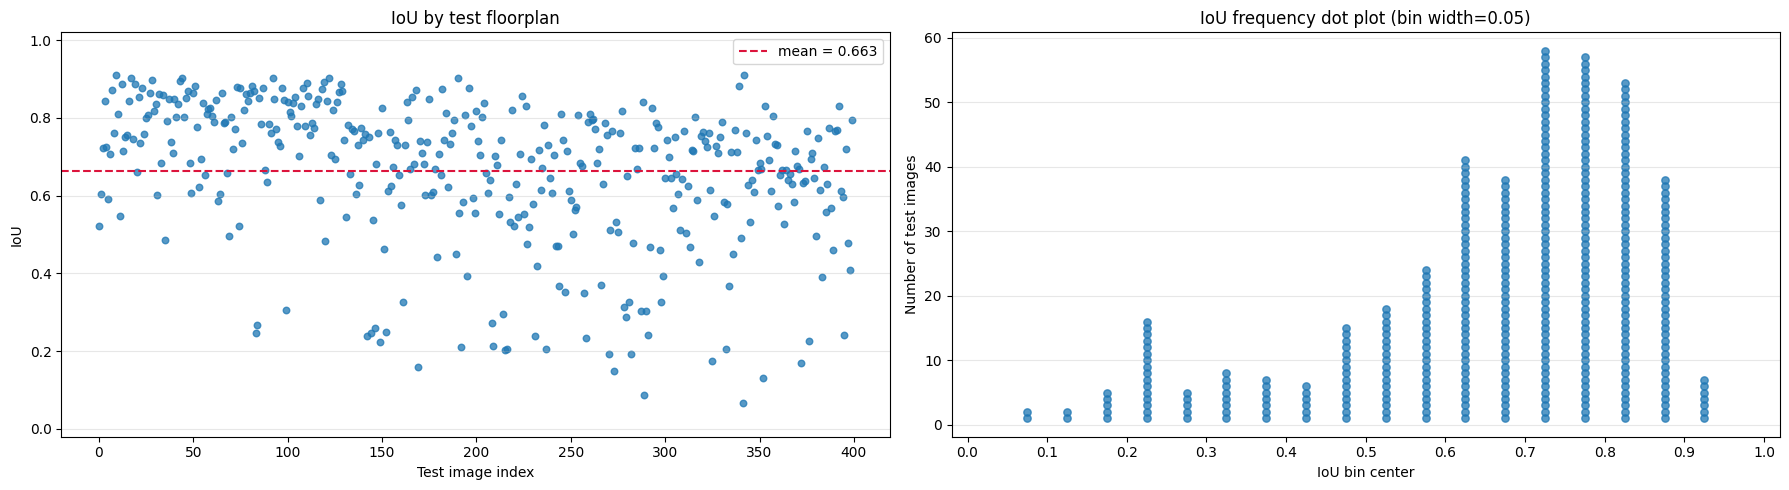
딱히 뭔가 특별한 개선은 보이지 않는다.
빈도표를 뽑아보면, 유독 낮은 20~30%가 전체 성능을 잡아먹는 것 같다.
이쯤에서, 참고 논문을 다시 보자.
실험 4. 비교점검. Ref 논문 1.
U-Net을 좀 파봐야 겠다고 마음먹게 된 논문이 바로 이 논문이다.
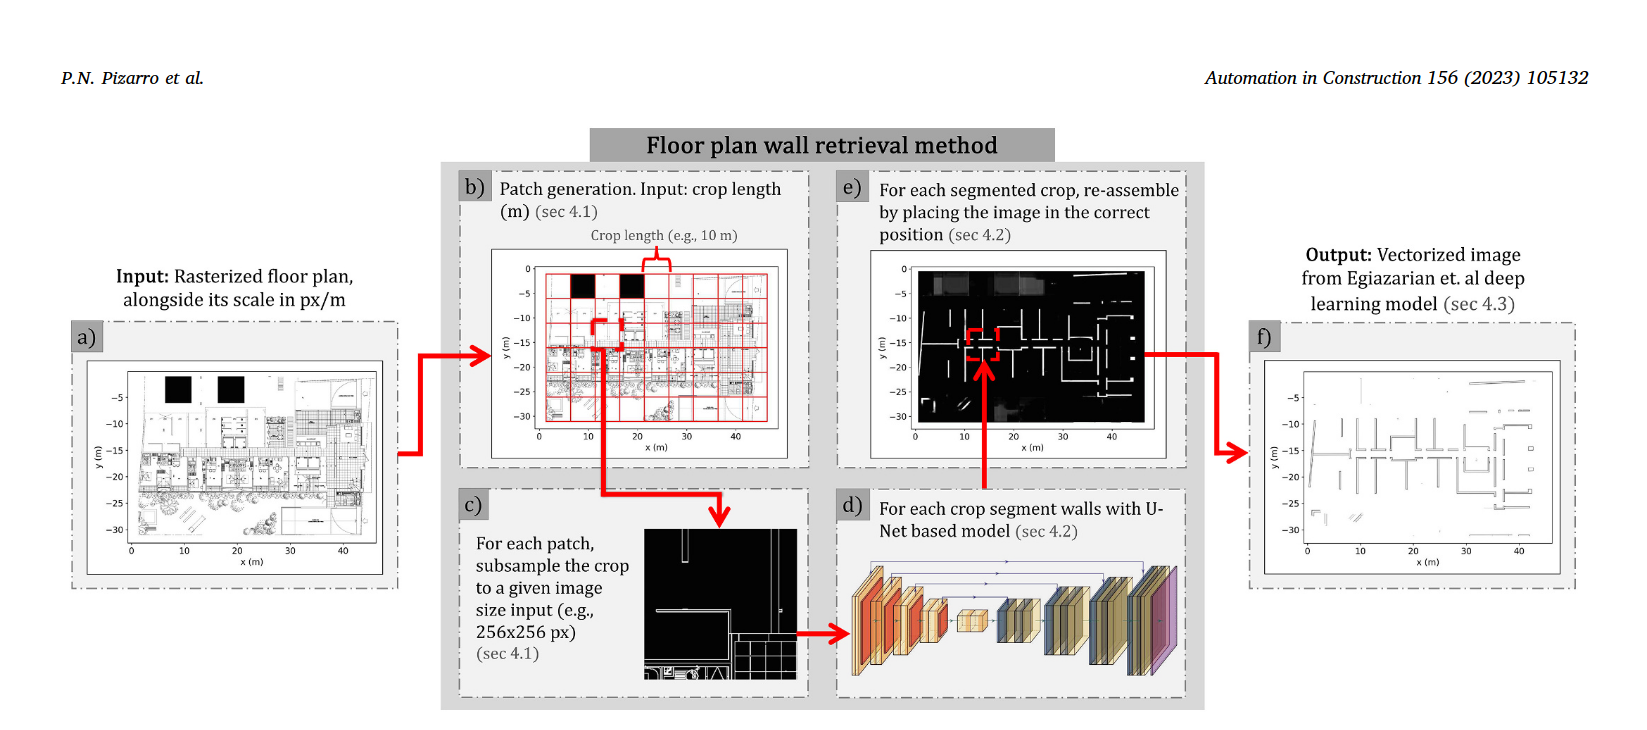
조금 다른 데이터셋을 사용하고 있지만, 우선 네트워크를 사용해서 도면에서 벽을 검출하는 방법에 대해 설명하고 있다.
현재 학습하고 있는 U-Net의 방향은 이 논문의 내용을 참조하여 진행중이다.
그래서 레퍼런스 논문과 무엇이 다른가를 한번 비교해보자.
| 구분 | Pizarro et al. (2023) | 현재 CubiCasa5K distilled |
|---|---|---|
| 데이터셋 | MLSTRUCT-FP | CubiCasa5K distilled |
| 도면 성격 | 대형 multi-unit 건축도면 | 주로 single-unit floor plan |
| 입력 채널 | 흑백 1채널 | RGB 3채널 |
| background tile | 제거 | 모두 사용 |
| preprocessing | grayscale + resample + sharpen | crop + normalize + augmentation |
| augmentation | 없음 | flip / rot90 등 |
| Pooling | Average Pooling | MaxPool |
| Loss | BCE | BCE + Dice |
| Optimizer | Adam, lr=1e-4 | 현재 Day2 설정 |
| 최종 출력 | wall primitive/vector | binary wall mask |
성능에 큰 영향을 주는 차이는 잘 보이지 않는데, 만약 있다고 한다면 Preprocessing의 Grayscale 변환이 조금 마음에 걸린다. 이 부분 한번 적용해서 진행해본다.
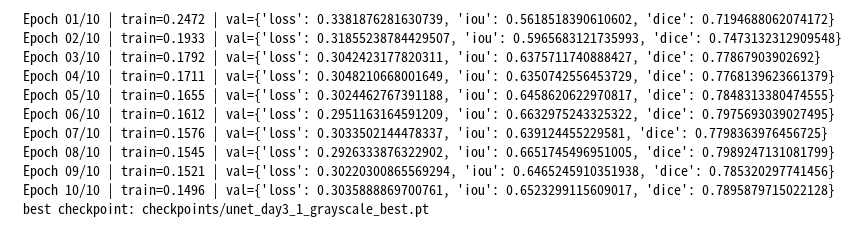
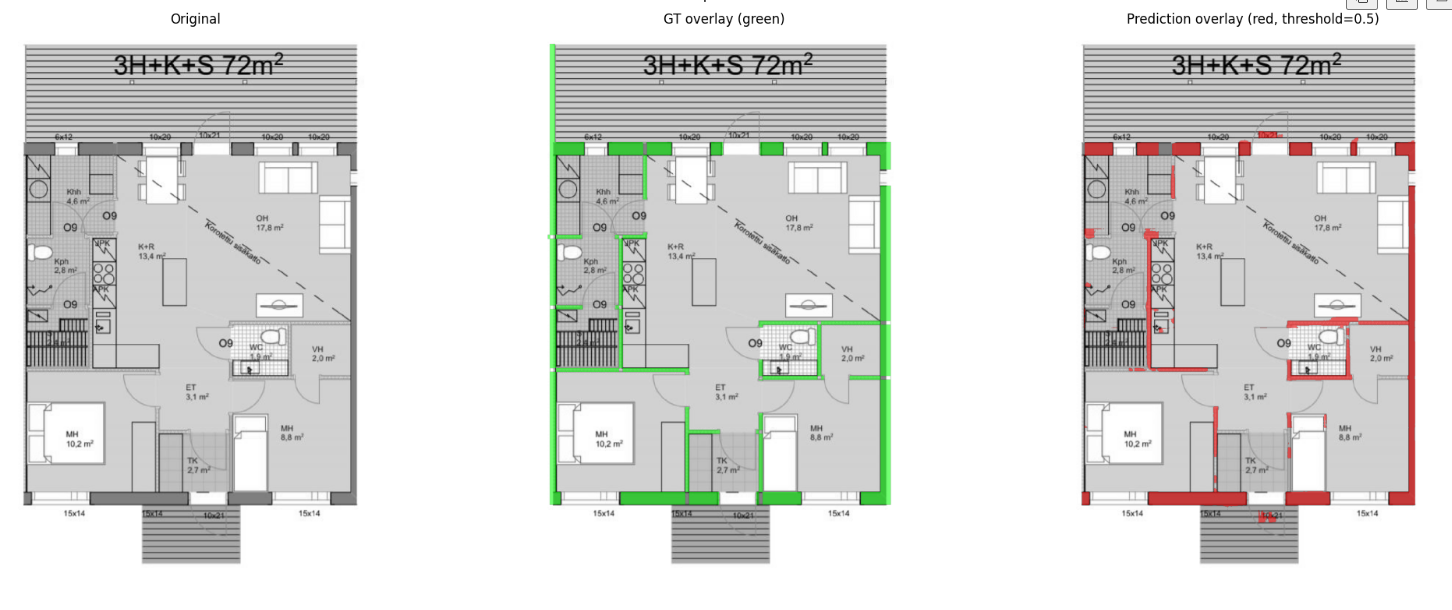
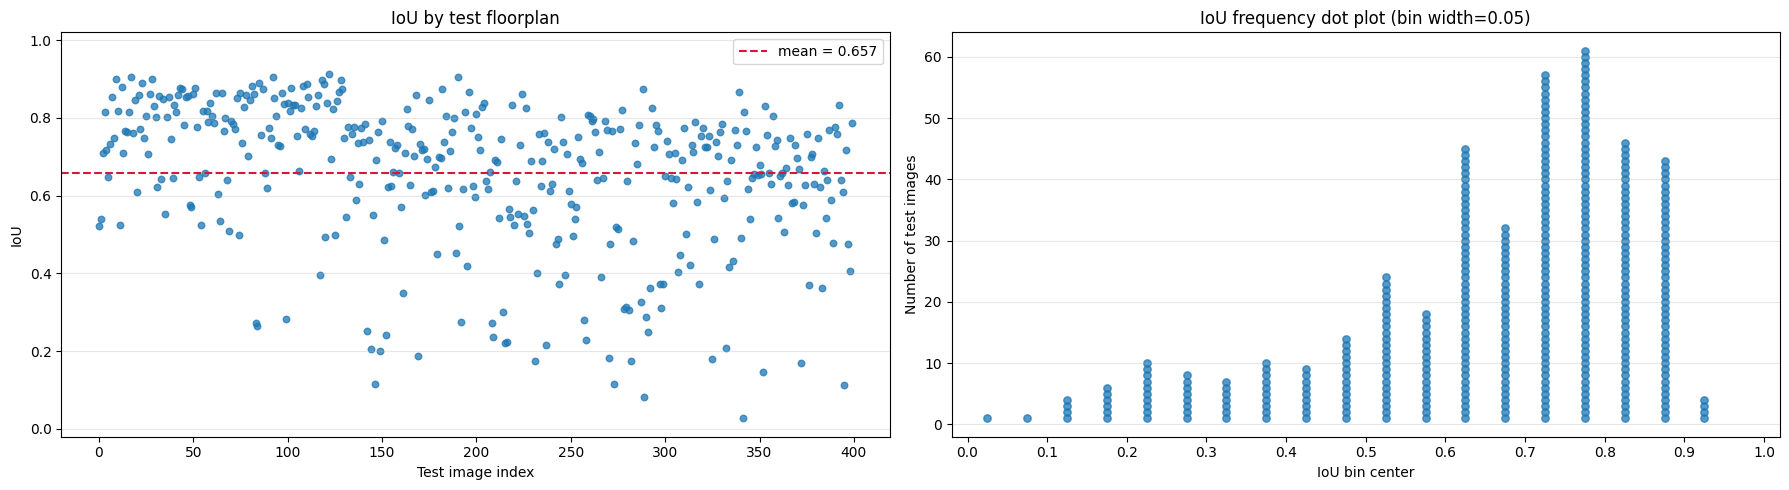
큰 차이는 보이지 않는다. 그래도 상대적인 집중도는 조~금 올라간듯 하다.
실험 5. 다른 Loss들
이후 추가적으로 고민해볼만한 Loss들이 등장한다. 자료 조사하다보니 이런 페이지도 나온다마는, 여기선 몇가지만 뽑아서 써보려 한다. 참고자료
Weighted BCE + Dice
BCE(Binary Cross Entrophy)는 각 픽셀을 독립적으로 이진분류한다.
\[L_{BCE} = -[y \log(p)+(1-y)\log(1-p)]\]이럴 경우, 이진분류 특성상, 0과 1로 나뉜 픽셀에서 0을 잘맞춰도 loss가 잘 나올 가능성이 있다. 즉 Background/Wall 로 나누었을때 Background를 잘 맞춰도 결과가 좋을 수 있는 것이다.
그래서 찾고싶은 Wall, 즉 Positive class에 더 큰 weight를 주는 방법이다.
\[L_{WBCE} = -[ \mathcal{w}_{p} y \log(p)+(1-y)\log(1-p)]\]여기서 $\mathcal{w}_p$ 가 가중치다. 파이토치에서는 간단하게 구현할 수 있다.
criterion = nn.BCEWithLogitsLoss(pos_weight=torch.tensor([5.0], device=device)) #가중치 5.0이 추가가 되었다.
여기에 Dice Loss를 다시 한번 상기해보자.
\[Dice = \frac{2TP}{2TP+FP+FN}\]이었다. 이 설계는 Wall 영역 전체를 잘 겹치게 하는 역할을 한다.
이 두 조합을 통해 wall 의 검출에 좀더 집중해볼 수 있다.
Focal Loss + Dice
Focal Loss 는 BCE의 변형이다.
기본 컨셉은 쉽게 맞추는 픽셀은 덜 신경쓰고, 틀리기 쉬운 픽셀에 집중하자는 것이 복적이다.
수식으로 표현하면 다음과 같다.
여기서 $p_t$는 정답 클래스에 대한 예측확율을 뜻한다. $ \gamma $ 는 보통 2정도로잡는다. 이때, $1- p_t$ 부분에서 $p_t$의 값이 높다면 0에 가까워지게 되고, 정답을 잘 못맞춘다면 1에 가까워지는 형태가 된다. 이걸 DiceLoss와 결합하여 사용하면 된다.
\[L = 0.5 L_{Focal}+0.5 L_{Dice}\]Tversky Loss
발음 어떻게 하는건지 정말 궁금했다. 티버스키 Loss라 한다. Tversky Loss는 Dice loss를 확장한 개념이다.
\[Dice = \frac{2TP}{2TP+FP+FN} = \frac{TP}{TP+0.5FP+0.5FN}\]Dice Loss가 이렇다면, Tversky loss는 위 식의 0.5에 해당하는 부분을 변수로 두고, $\alpha$, $\beta$ 로 두어 차등을 둔다.
\[TI = \frac{TP}{TP+\alpha FP+\beta FN}\]$\alpha = 0.3$, $\beta = 0.7$ 형태로 차등을 두면 FN 에 패널티를 더 주는 형태가 된다.
Focal Tversky
앞서서 이야기한 Focal Loss, Tversky loss를 합친 형태가 된다.
\[{FTL} = (1-TI)^\gamma\]여기까지의 Loss들을 한번 비교해보자.
비교결과
Base Line은 시간관계상 생략하고 추가실험했더니 Base line이 그래프에 안나온다만, Base line의 IoU 는 0.652였고, Dice는 0.790 수준이였다.
Focal Loss와 Tversky loss를 비교해봤을때, 그렇게 개선이 되는것 처럼 보이진 않는다.
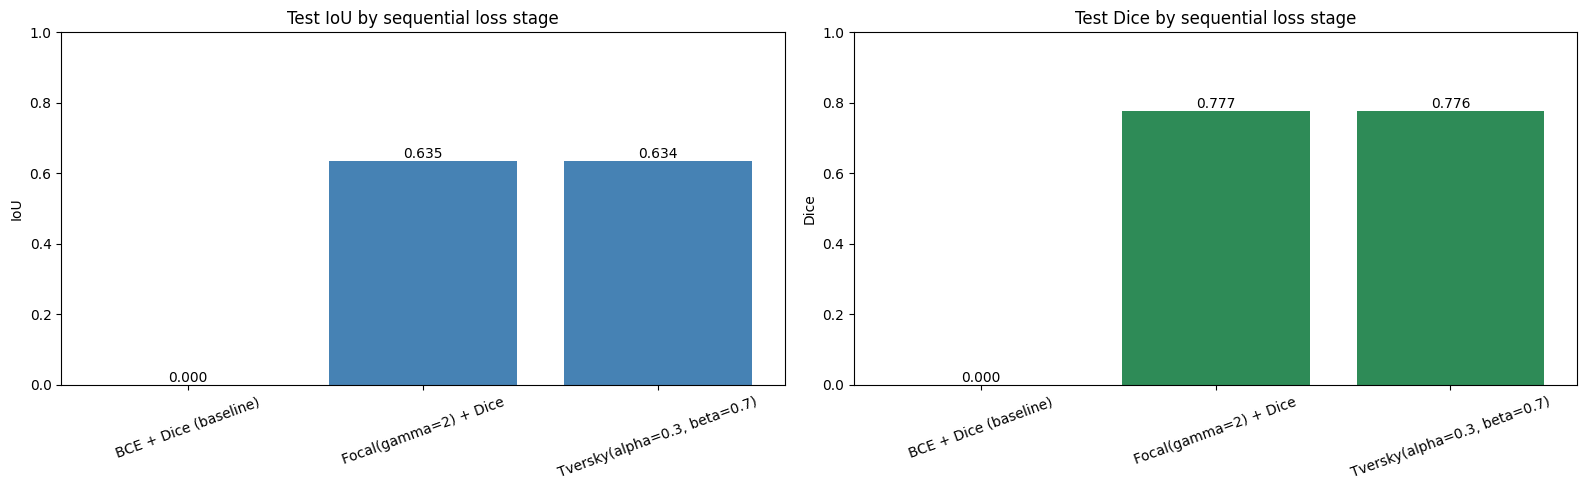
조금 눈에 띄는 결과가 있다면 Tversky loss의 경우 IoU값의 산포가 상대적으로 좋다.
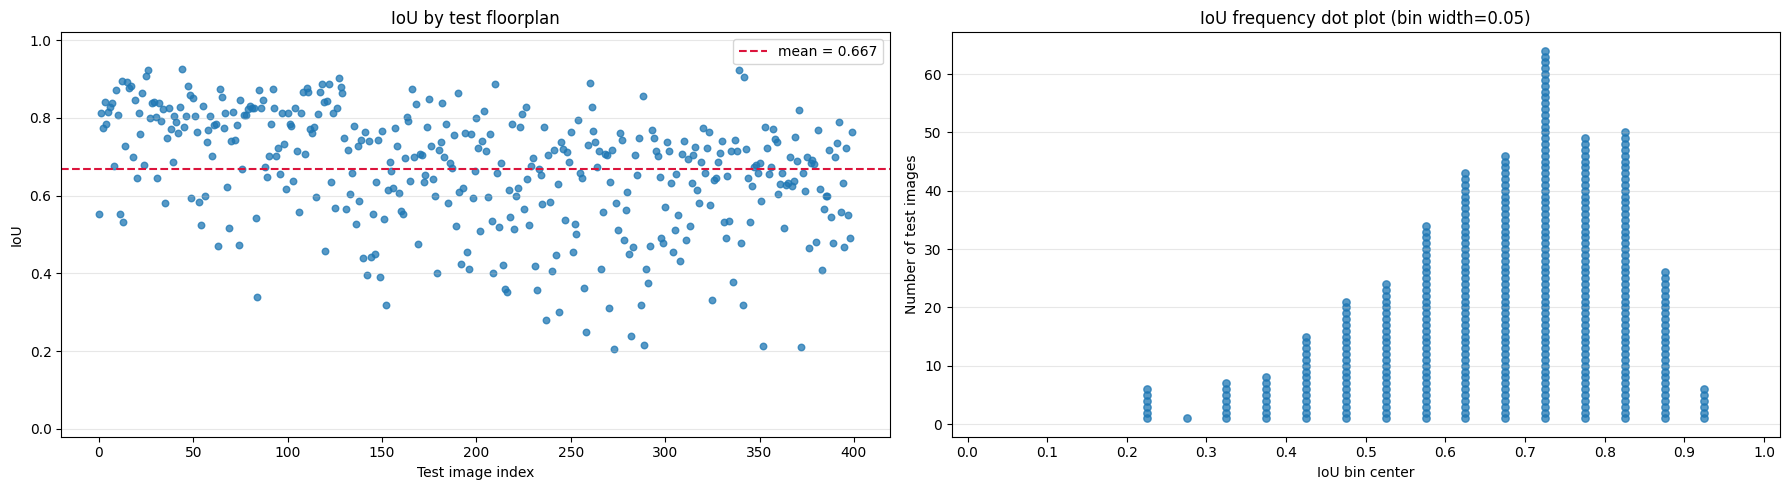
이로 미루어 보건데, Loss의 변경은 큰 틀에서의 성능을 가져오지는 못하지만 마지막 fine tuning수준의 의미정도는 부여할 수 있는 듯하다.
그리고, 참고로 Focal-Tversky 복합 Loss는 실험중 발산했다. 안되는건 있는가보다.
오늘의 결론
이번 튜토리얼을 통해, 실제 목표인 건축도면을 불러와서 데이터셋 전처리를 해보았고, U-Net을 이용하여 다양한 Loss 들을 비교해보면서 성능 개선을 시도해봤다.
특히 데이터를 전처리하는 과정과, 대형 이미지에 대해 네트워크 학습을 어떻게 시킬 것인지에 대해 집중적으로 다루어보았다.
Loss 함수들을 바꾸었을때, 전체적인 성능의 향상보다는, 적절한 Loss 함수의 선택시 Output 의 성능이 조금 더 균일하게 나오는 효과를 확인할 수 있었다.
| Loss | 주요 특징 | 기대 효과 |
|---|---|---|
| Weighted BCE + Dice | 클래스별 가중치 적용 | Class Imbalance 대응 |
| Focal + Dice | 어려운 픽셀에 집중 | 오분류 영역 개선 |
| Tversky Loss | FP와 FN의 가중치 조절 | Precision / Recall 조절 |
| Focal Tversky Loss | Tversky와 Focal 개념 결합 | 어려운 벽 영역 학습 |
| Boundary-aware Loss | 경계 오차 반영 | 벽 경계 정확도 개선 |
이제, Encoder/Decoder에 대해 조금 더 다른 접근을 통해서 실제 사용가능한 수준으로 성능을 끌어올려보자.
끗.
댓글남기기