Semantic Segmentation, U-Net Day 2.5
이미지에서 특정 패턴을 추출해보자.
들어가면서.
지난 시간에 Oxford IIIT Pet 데이터셋을 이용해서 전체 프레임워크를 한번 구성해봤다.
데이터셋을 어떻게 전처리하고, 어떻게 네트워크를 구성하고, 성능 확인까지 주욱 훑어 내려갔다.
전처리에선 Nearest interpolation이 있었고, 네트워크는 double conv이 4번에 걸쳐 이어졌다.
그런데 실제로 그렇게 확인해본 네트워크의 성능은 그닥 신뢰하기 어려운 수준이었다.
내가 전해 들었던 U-Net이 맞나? 싶은 수준이었다.
이제 실전 데이터셋으로 넘어가기 전에 이 네트워크의 성능을 좀 더 높이는 방법에는 무엇이 있는지 짚고 넘어가보자.
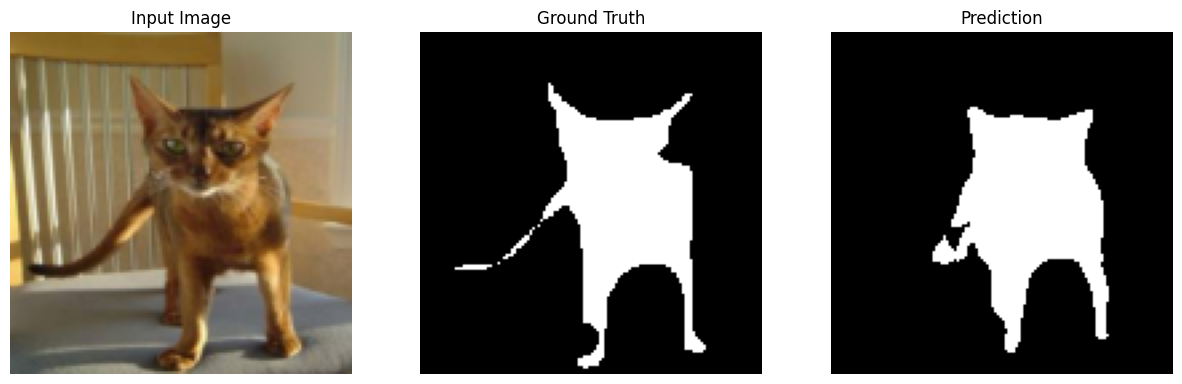
실험결과에 대한 고찰.
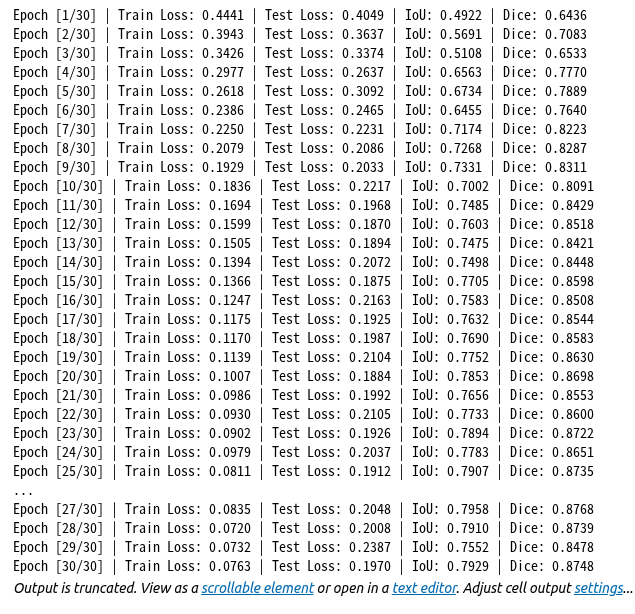
좀 고민을 해보자.
-
Train loss는 계속 감소한다. → Training data는 점점 잘 맞추고 있다.
-
Test loss는 빨리 수렴했고, 흔들린다 → 과적합이 나타나기 시작하는 전형적인 형태다. → Augmentation, Weight Decay, Scheduler, Early stopping 이 의미가 생긴다.
-
IoU는 계속 좋아질까? Loss 가 낮다고 해도 IoU가 높은 모델이라 할순 없다 → BCE Loss말고 IoU나 Dice를 Loss로 하는게 의미가 생긴다.
실험 설정
방금전의 고찰을 바탕으로 튜닝인자를 선정하고, 설정해보자.
먼저 튜닝하는 부분의 코드를 먼저 뽑아보자.
# ============================================================
# U-Net Day 2.5 - Experiment Configuration
# ============================================================

# -----------------------------
# Basic
# -----------------------------
NUM_EPOCHS = 30
BATCH_SIZE = 8
LEARNING_RATE = 1e-3
SEED = 42

# -----------------------------
# Model
# -----------------------------
BASE_CHANNELS = 64

# -----------------------------
# Loss
# 하나만 활성화
# -----------------------------
LOSS_TYPE = "bce"

# LOSS_TYPE = "dice"
# LOSS_TYPE = "bce_dice"

# -----------------------------
# Optimizer
# 하나만 활성화
# -----------------------------
OPTIMIZER_TYPE = "adam"

# OPTIMIZER_TYPE = "adamw"

# -----------------------------
# Learning Rate Scheduler
# -----------------------------
USE_SCHEDULER = False

# -----------------------------
# Data Augmentation
# -----------------------------
USE_AUGMENTATION = False

# -----------------------------
# Early Stopping
# -----------------------------
USE_EARLY_STOPPING = False
PATIENCE = 5
위 코드에서 선정한 인자는 5개다.
| 실험 | 변경 사항 | 배우는 내용 |
|---|---|---|
| Baseline | 기존 U-Net + BCE | 기준 성능 |
| ① Loss | BCE → BCE+Dice | Segmentation 전용 Loss |
| ② Augmentation | Flip/Crop 등 | 데이터 다양성 증가 |
| ③ Optimizer | Adam → AdamW | 최적화 방법 |
| ④ LR Scheduler | LR 자동 감소 | 학습 후반 안정화 |
| ⑤ Early Stopping | 최적 epoch 저장 | Overfitting 방지 |
이걸 바탕으로 실험계획을 세워본다면 다음과 같다.
| Experiment | Loss | Augmentation | Optimizer | Scheduler | Best IoU | Best Dice |
|---|---|---|---|---|---|---|
| Baseline | BCE | X | Adam | X | 0.799 | 0.877 |
| Exp 1 | BCE+Dice | X | Adam | X | ? | ? |
| Exp 2 | BCE+Dice | O | Adam | X | ? | ? |
| Exp 3 | BCE+Dice | O | AdamW | X | ? | ? |
| Exp 4 | BCE+Dice | O | AdamW | O | ? | ? |
이후에 좀더 알아본다면 다음과 같은 것들이 있겠다만, 일단 지금은 지금의 네트워크를 손대지 않는 수준에서 얼마나 좋아지는지 한번 보도록 하자.
아래는 이후의 후보들이다.
- BatchNorm
- Dropout
- U-Net 채널 수 변경
- Pretrained Encoder
- ResNet U-Net
- Attention U-Net
1. Import / Device 설정
# ============================================================
# 1. Import
# ============================================================

import random
import numpy as np
import matplotlib.pyplot as plt

import torch
import torch.nn as nn

from torch.utils.data import DataLoader

import torchvision
from torchvision.datasets import OxfordIIITPet
from torchvision.transforms import functional as TF

from PIL import Image


# ============================================================
# Random Seed
# ============================================================

random.seed(SEED)
np.random.seed(SEED)

torch.manual_seed(SEED)

if torch.cuda.is_available():
    torch.cuda.manual_seed_all(SEED)


# ============================================================
# Device
# ============================================================

device = torch.device(
    "cuda" if torch.cuda.is_available() else
    "mps" if torch.backends.mps.is_available() else
    "cpu"
)

print("Device :", device)
코드의 상세한 설명은 Day2를 참고하자.
2. Dataset
데이터셋은 이미 받았다고 가정한다.
모든건 Day2의 나에게 맡긴다.
그리고 Day2에서 조금 바뀌어 볼게 여기서 하나있는데, Data Augmentation 옵션을 정의해야 한다.
2-1. Paired Transform
DataAugmentation을 하려면, Segmentation에서는 이미지와 마스크를 동시에 같은 방식으로 변환해야 한다. 이미지만 좌우 반전하고 mask는 그대로 두면 학습 데이터가 틀어진다. 그래서 paired로 변환한다.
# ============================================================
# 2-1. Image + Mask Transform
# ============================================================

class SegmentationTransform:

    def __init__(self, image_size=128, augmentation=False):

        self.image_size = image_size
        self.augmentation = augmentation


    def __call__(self, image, mask):

        # ----------------------------------------------------
        # Resize
        # ----------------------------------------------------

        image = TF.resize(
            image,
            [self.image_size, self.image_size],
            interpolation=TF.InterpolationMode.BILINEAR
        )

        mask = TF.resize(
            mask,
            [self.image_size, self.image_size],
            interpolation=TF.InterpolationMode.NEAREST
        )


        # ----------------------------------------------------
        # Data Augmentation
        # ----------------------------------------------------

        if self.augmentation:

            # Horizontal Flip
            if random.random() < 0.5:

                image = TF.hflip(image)
                mask = TF.hflip(mask)


        # ----------------------------------------------------
        # Image -> Tensor
        # ----------------------------------------------------

        image = TF.to_tensor(image)


        # ----------------------------------------------------
        # Mask -> Binary Tensor
        #
        # Oxford Pet trimap에서
        # label 1을 pet foreground로 사용
        # ----------------------------------------------------

        mask = torch.as_tensor(
            np.array(mask),
            dtype=torch.long
        )

        mask = (mask == 1).float()

        # [H,W] → [1,H,W]
        mask = mask.unsqueeze(0)


        return image, mask
2-2. Dataset Wrapper
# ============================================================
# 2-2. Dataset Wrapper
# ============================================================

class PetSegmentationDataset(torch.utils.data.Dataset):

    def __init__(
        self,
        root,
        split,
        transform
    ):

        self.dataset = OxfordIIITPet(
            root=root,
            split=split,
            target_types="segmentation",
            download=True
        )

        self.transform = transform


    def __len__(self):

        return len(self.dataset)


    def __getitem__(self, index):

        image, mask = self.dataset[index]

        image, mask = self.transform(
            image,
            mask
        )

        return image, mask
2-3. Train / Validation Dataset
여기서부터는 Test라는 이름 대신 Validation을 사용한다.
# ============================================================
# 2-3. Dataset
# ============================================================
IMAGE_SIZE = 128
train_transform = SegmentationTransform(
    image_size=IMAGE_SIZE,
    augmentation=USE_AUGMENTATION
)

val_transform = SegmentationTransform(
    image_size=IMAGE_SIZE,
    augmentation=False
)


train_dataset = PetSegmentationDataset(
    root="./data",
    split="trainval",
    transform=train_transform
)


val_dataset = PetSegmentationDataset(
    root="./data",
    split="test",
    transform=val_transform
)


print("Train :", len(train_dataset))
print("Validation :", len(val_dataset))
2-4. DataLoader
# ============================================================
# 2-4. DataLoader
# ============================================================

train_loader = DataLoader(
    train_dataset,
    batch_size=BATCH_SIZE,
    shuffle=True
)


val_loader = DataLoader(
    val_dataset,
    batch_size=BATCH_SIZE,
    shuffle=False
)


print("Train batches :", len(train_loader))
print("Val batches   :", len(val_loader))
3. U-Net
여기서는 Base channels를 수정할 수 있다.
# ============================================================
# 3. U-Net
# ============================================================

class DoubleConv(nn.Module):

    def __init__(self, in_channels, out_channels):

        super().__init__()

        self.conv = nn.Sequential(

            nn.Conv2d(
                in_channels,
                out_channels,
                kernel_size=3,
                padding=1
            ),

            nn.ReLU(inplace=True),

            nn.Conv2d(
                out_channels,
                out_channels,
                kernel_size=3,
                padding=1
            ),

            nn.ReLU(inplace=True)
        )


    def forward(self, x):

        return self.conv(x)
4. Loss 함수
Loss함수에선 BCE, Dice, BCE+Dice Loss를 비교해본다.
4-1. Dice Loss
Dice score를 복기해보자.
\[Dice = \frac{2|P \cap G|}{|P| + |G|}\]였다. 학습에서는 이 Dice가 커지도록 설정해야 하므로, Dice Loss는 다음과 같이 정의해볼 수 있다.
\[DiceLoss = 1 - DiceScore\]# ============================================================
# 4-1. Dice Loss
# ============================================================
class DiceLoss(nn.Module):
def __init__(self, smooth=1e-6):
super().__init__()
self.smooth = smooth
def forward(self, logits, targets):
probabilities = torch.sigmoid(logits)
probabilities = probabilities.view(
probabilities.size(0),
-1
)
targets = targets.view(
targets.size(0),
-1
)
intersection = (
probabilities * targets
).sum(dim=1)
dice = (
2.0 * intersection + self.smooth
) / (
probabilities.sum(dim=1)
+ targets.sum(dim=1)
+ self.smooth
)
return 1.0 - dice.mean()
4-2. BCE + Dice Loss
실무에서 많이 쓰는 방식이라고 한다. BCE Loss와 Dice Loss를 더한 값이다.
\[LOSS = BCE + DiceLoss\]# ============================================================
# 4-2. BCE + Dice Loss
# ============================================================
class BCEDiceLoss(nn.Module):
def __init__(self):
super().__init__()
self.bce = nn.BCEWithLogitsLoss()
self.dice = DiceLoss()
def forward(self, logits, targets):
bce_loss = self.bce(
logits,
targets
)
dice_loss = self.dice(
logits,
targets
)
return bce_loss + dice_loss
4-3. Loss 선택
실험 설정에 따라 Loss를 선택하게 한다.
# ============================================================
# 4-3. Select Loss
# ============================================================

if LOSS_TYPE == "bce":

    criterion = nn.BCEWithLogitsLoss()


elif LOSS_TYPE == "dice":

    criterion = DiceLoss()


elif LOSS_TYPE == "bce_dice":

    criterion = BCEDiceLoss()


else:

    raise ValueError(
        f"Unknown LOSS_TYPE: {LOSS_TYPE}"
    )


print("Loss :", LOSS_TYPE)
5. Model / Optimizer / Scheduler
5-1. Model 생성
빠르게 가보자.
# ============================================================
# 5-1. Model
# ============================================================

model = UNet(
    in_channels=3,
    out_channels=1,
    base_channels=BASE_CHANNELS
)

model = model.to(device)


print(model.__class__.__name__)
5-2. Optimizer 선택
# ============================================================
# 5-2. Optimizer
# ============================================================

if OPTIMIZER_TYPE == "adam":

    optimizer = torch.optim.Adam(
        model.parameters(),
        lr=LEARNING_RATE
    )


elif OPTIMIZER_TYPE == "adamw":

    optimizer = torch.optim.AdamW(
        model.parameters(),
        lr=LEARNING_RATE,
        weight_decay=WEIGHT_DECAY
    )


else:

    raise ValueError(
        f"Unknown optimizer: {OPTIMIZER_TYPE}"
    )


print("Optimizer :", OPTIMIZER_TYPE)
5-3. Scheduler
이번에는 ReduceLROnPlateau를 준비한다.
Validation Loss가 더 이상 좋아지지 않으면 learining rate를 낮춘다.
# ============================================================
# 5-3. Scheduler
# ============================================================

scheduler = None


if USE_SCHEDULER:

    scheduler = torch.optim.lr_scheduler.ReduceLROnPlateau(
        optimizer,
        mode="min",
        factor=0.5,
        patience=2
    )


print("Scheduler :", USE_SCHEDULER)
6. IoU / Dice Metric
# ============================================================
# 6. Metrics
# ============================================================

def calculate_metrics(
    logits,
    targets,
    threshold=0.5,
    smooth=1e-6
):

    probabilities = torch.sigmoid(logits)

    predictions = (
        probabilities > threshold
    ).float()


    predictions = predictions.view(
        predictions.size(0),
        -1
    )

    targets = targets.view(
        targets.size(0),
        -1
    )


    intersection = (
        predictions * targets
    ).sum(dim=1)


    union = (
        predictions
        + targets
        - predictions * targets
    ).sum(dim=1)


    iou = (
        intersection + smooth
    ) / (
        union + smooth
    )


    dice = (
        2 * intersection + smooth
    ) / (
        predictions.sum(dim=1)
        + targets.sum(dim=1)
        + smooth
    )


    return (
        iou.mean().item(),
        dice.mean().item()
    )
7. Training 함수
Day 2의 training loop를 함수 형태로 정리한다.
## 7-1. Train
 # ============================================================
# 7-1. Train One Epoch
# ============================================================

def train_one_epoch(
    model,
    loader,
    optimizer,
    criterion,
    device
):

    model.train()

    total_loss = 0.0


    for images, masks in loader:

        images = images.to(device)
        masks = masks.to(device)


        # Forward
        logits = model(images)

        loss = criterion(
            logits,
            masks
        )


        # Backward
        optimizer.zero_grad()

        loss.backward()

        optimizer.step()


        total_loss += loss.item()


    return total_loss / len(loader)
7-2. Validation
# ============================================================
# 7-2. Validation
# ============================================================

def validate(
    model,
    loader,
    criterion,
    device
):

    model.eval()


    total_loss = 0.0
    total_iou = 0.0
    total_dice = 0.0


    with torch.no_grad():

        for images, masks in loader:

            images = images.to(device)
            masks = masks.to(device)


            logits = model(images)


            loss = criterion(
                logits,
                masks
            )


            iou, dice = calculate_metrics(
                logits,
                masks
            )


            total_loss += loss.item()

            total_iou += iou

            total_dice += dice


    n = len(loader)


    return (
        total_loss / n,
        total_iou / n,
        total_dice / n
    )
8. Training 실행
이 부분에서 다음 기록을 모두 저장한다.
- Train Loss
- Validation Loss
- IoU
- Dice
- Learning Rate
 # ============================================================
# 8. Training
# ============================================================

history = {

    "train_loss": [],
    "val_loss": [],
    "iou": [],
    "dice": [],
    "lr": []

}


best_iou = 0.0

epochs_without_improvement = 0


# Training configuration
print("\nTraining configuration")
print(f"  NUM_EPOCHS         : {NUM_EPOCHS}")
print(f"  BATCH_SIZE         : {BATCH_SIZE}")
print(f"  LEARNING_RATE      : {LEARNING_RATE}")
print(f"  LOSS_TYPE          : {LOSS_TYPE}")
print(f"  OPTIMIZER_TYPE     : {OPTIMIZER_TYPE}")
print(f"  USE_AUGMENTATION   : {USE_AUGMENTATION}")
print(f"  USE_SCHEDULER      : {USE_SCHEDULER}")
print(f"  USE_EARLY_STOPPING : {USE_EARLY_STOPPING}")
print()


for epoch in range(NUM_EPOCHS):


    # --------------------------------------------------------
    # Train
    # --------------------------------------------------------

    train_loss = train_one_epoch(
        model,
        train_loader,
        optimizer,
        criterion,
        device
    )


    # --------------------------------------------------------
    # Validation
    # --------------------------------------------------------

    val_loss, val_iou, val_dice = validate(
        model,
        val_loader,
        criterion,
        device
    )


    # --------------------------------------------------------
    # Scheduler
    # --------------------------------------------------------

    if scheduler is not None:

        scheduler.step(val_loss)


    current_lr = optimizer.param_groups[0]["lr"]


    # --------------------------------------------------------
    # History
    # --------------------------------------------------------

    history["train_loss"].append(
        train_loss
    )

    history["val_loss"].append(
        val_loss
    )

    history["iou"].append(
        val_iou
    )

    history["dice"].append(
        val_dice
    )

    history["lr"].append(
        current_lr
    )


    # --------------------------------------------------------
    # Best Model
    # --------------------------------------------------------

    if val_iou > best_iou:

        best_iou = val_iou

        epochs_without_improvement = 0


        torch.save(
            model.state_dict(),
            "best_unet.pth"
        )


    else:

        epochs_without_improvement += 1


    # --------------------------------------------------------
    # Print
    # --------------------------------------------------------

    print(

        f"Epoch [{epoch+1:2d}/{NUM_EPOCHS}] | "

        f"Train Loss: {train_loss:.4f} | "

        f"Val Loss: {val_loss:.4f} | "

        f"IoU: {val_iou:.4f} | "

        f"Dice: {val_dice:.4f} | "

        f"LR: {current_lr:.6f}"

    )


    # --------------------------------------------------------
    # Early Stopping
    # --------------------------------------------------------

    if USE_EARLY_STOPPING:

        if epochs_without_improvement >= PATIENCE:

            print(
                f"\nEarly stopping at epoch {epoch+1}"
            )

            break
실험결과
| 단계 | Loss | Aug. | Optimizer | Scheduler | Early Stop | IoU | Dice | Train Loss | Validation Loss |
|---|---|---|---|---|---|---|---|---|---|
| Exp 0 | BCE | X | Adam | X | X | 0.7020 | 0.8109 | 0.0933 | 0.3605 |
| Exp 1 | BCE+Dice | X | Adam | X | X | 0.7331 | 0.8325 | 0.1894 | 0.4952 |
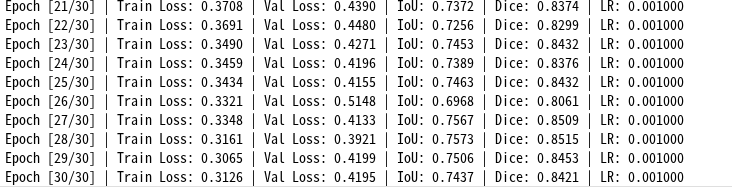
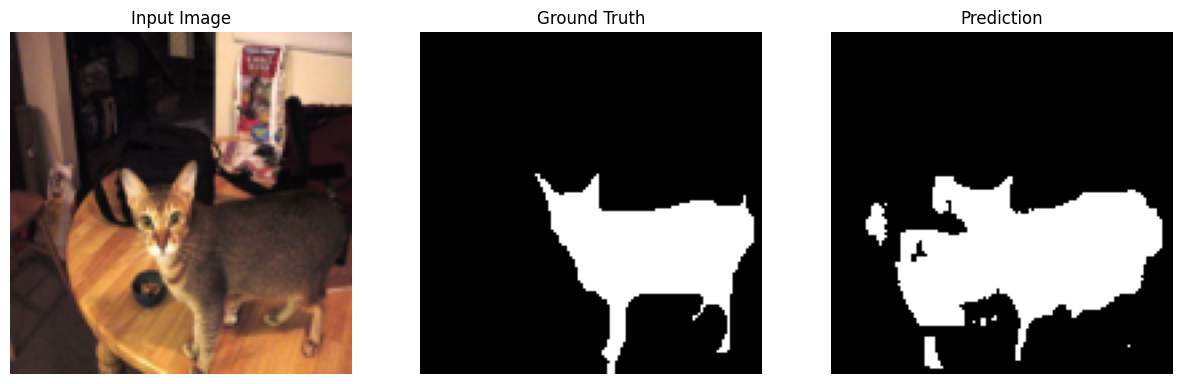
| Exp 2 | BCE+Dice | O | Adam | X | X | 0.7506 | 0.8453 | 0.3065 | 0.4199 |
| Exp 3 | BCE+Dice | O | AdamW | X | X | 0.7516 | 0.8472 | 0.3140 | 0.4070 |
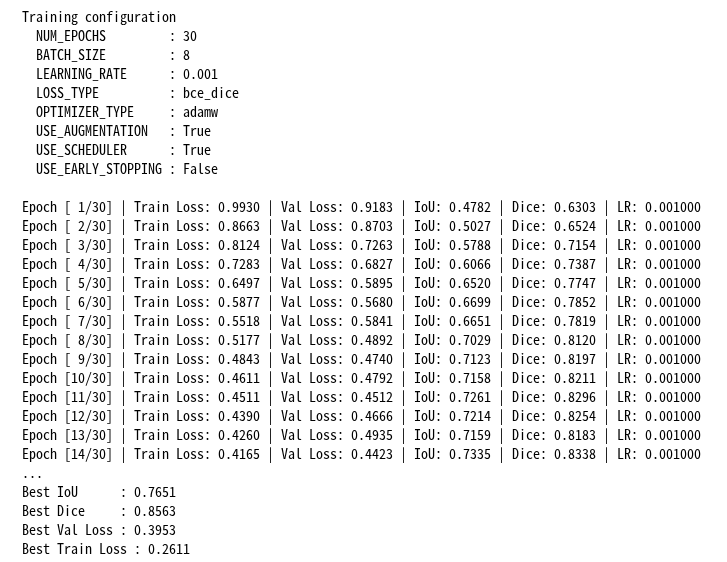
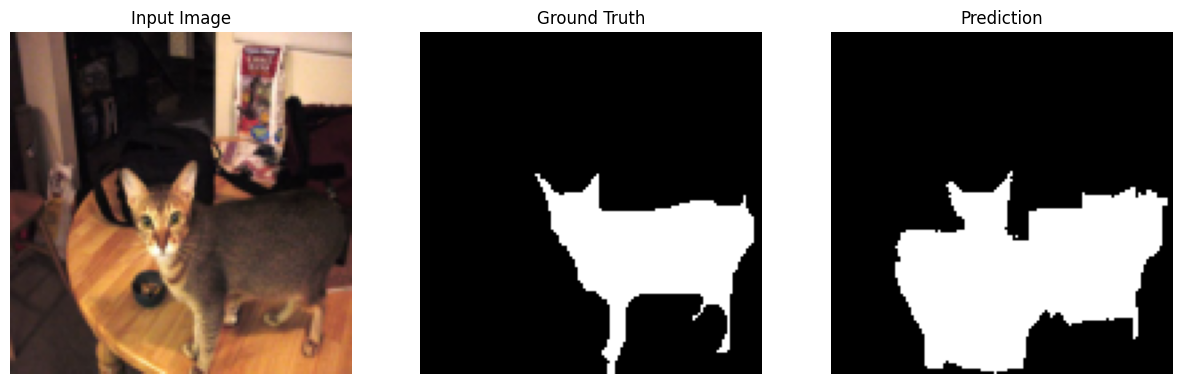
| Exp 4 | BCE+Dice | O | AdamW | O | X | 0.7651 | 0.8563 | 0.2611 | 0.3953 |
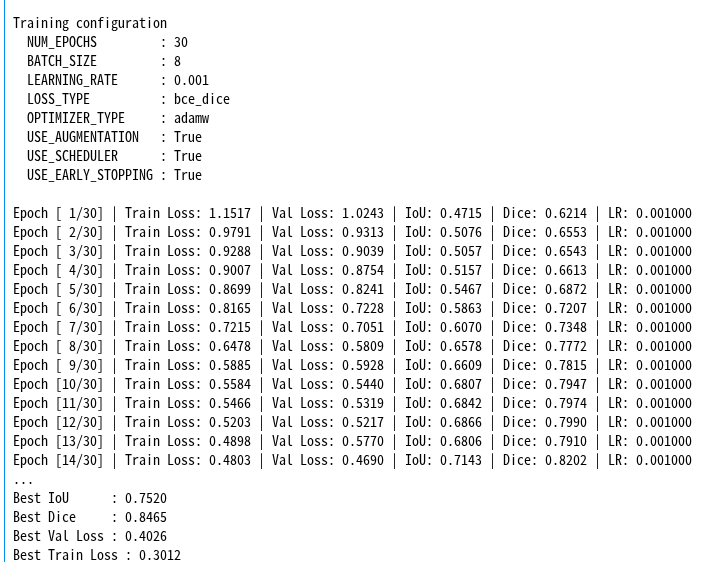
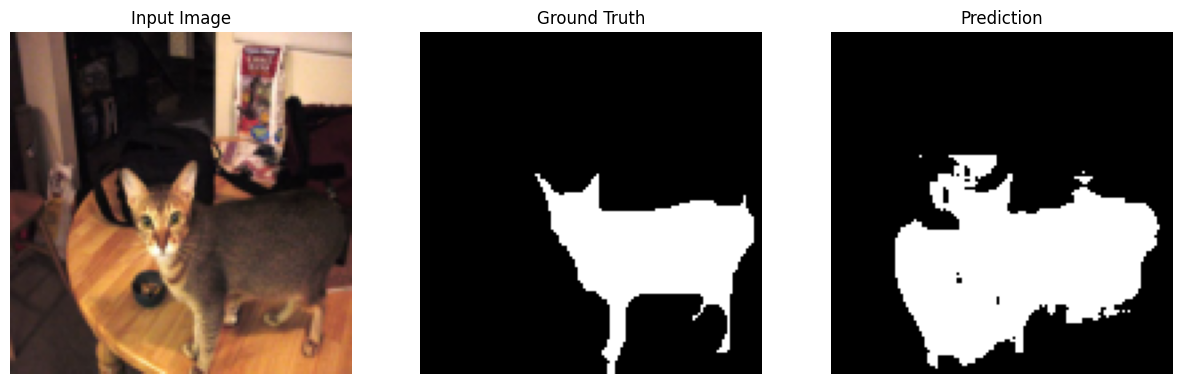
| Exp 5 | BCE+Dice | O | AdamW | O | O | 0.7520 | 0.8465 | 0.0.3012 | 0.4026 |
Exp 0. Baseline
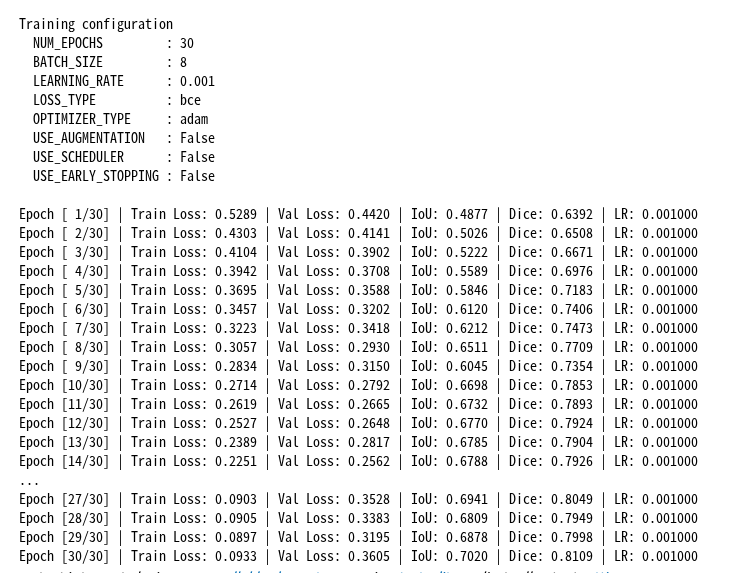
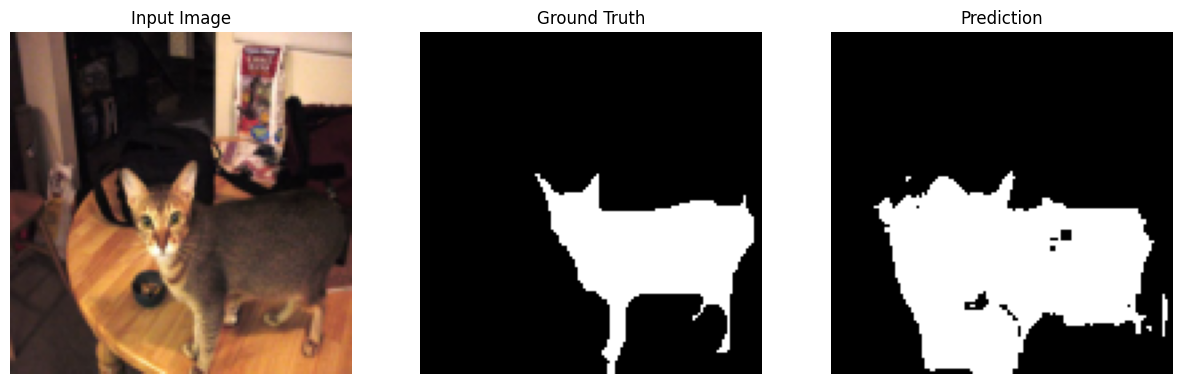
Exp1. BCE_Dice
..더 엉망인데?
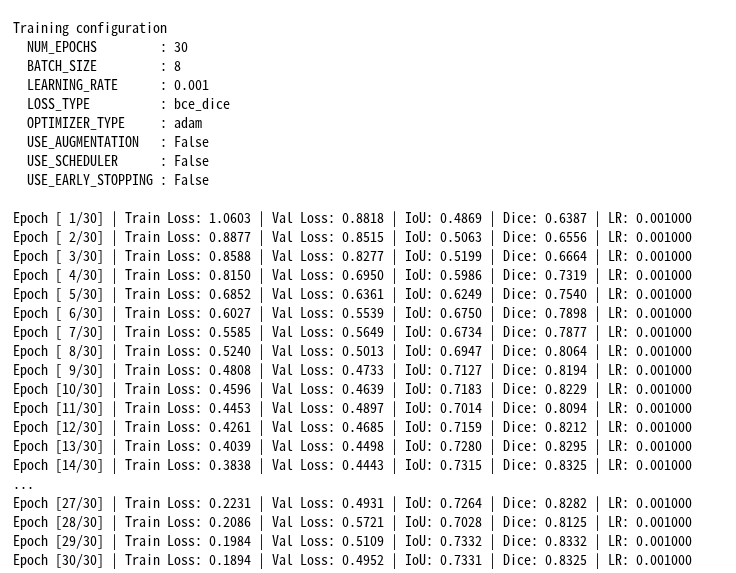
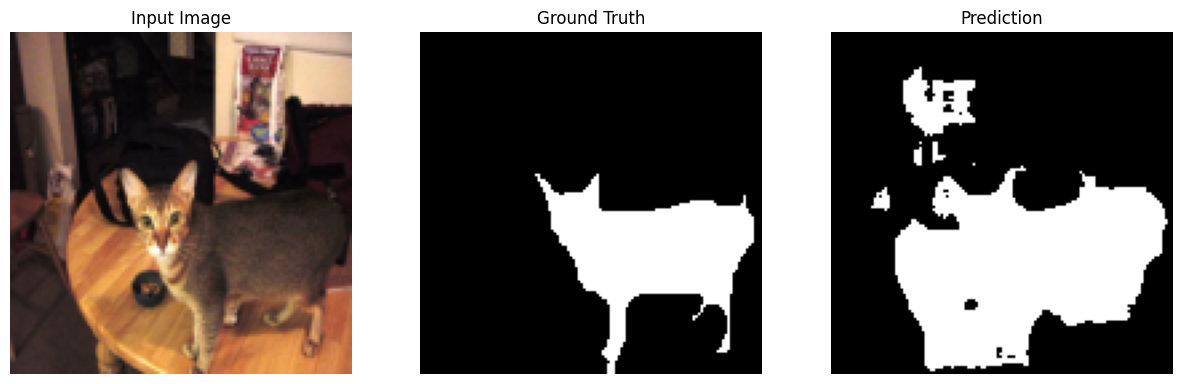
Exp2. Augmentation
Exp 3. Optimizer, AdamW
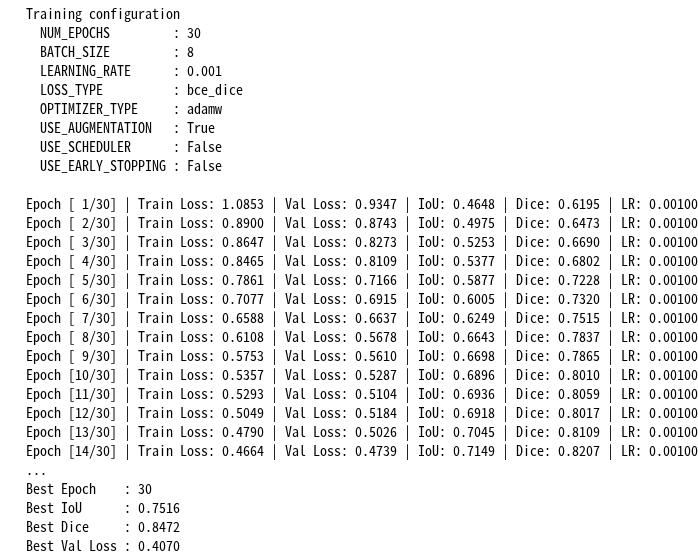
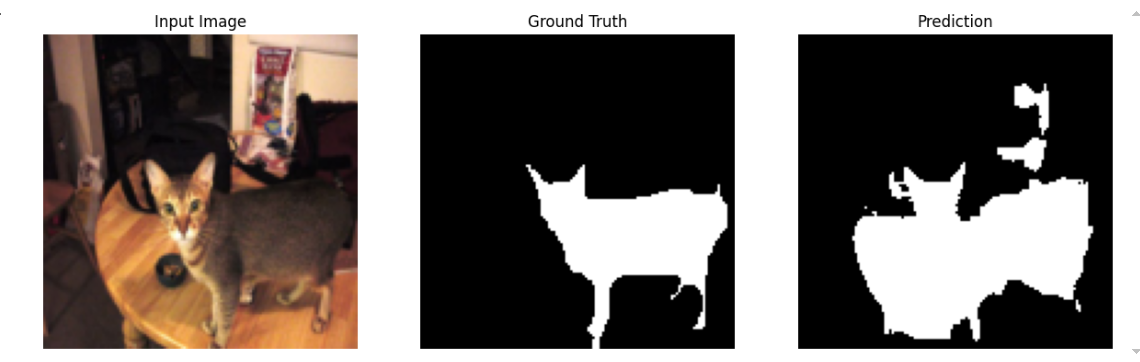
야랄이구만.
Exp 4. Scheduler
Exp 5. Early Stop
중간고찰.
왜 Day 2보다 못하지 해서 정리해보니 다음과 같다.
| 항목 | unet_day2.ipynb |
unet_day2_5.ipynb |
|---|---|---|
IMAGE_SIZE |
(128, 128) — Dataset 기본값 |
128 — 설정 셀에서 명시 |
| 실제 입력/출력 크기 | 3 × 128 × 128 → 1 × 128 × 128 |
동일 |
BASE_CHANNELS |
별도 변수 없이 첫 채널을 64로 고정 |
BASE_CHANNELS = 64, 모델 생성 시 base_channels=BASE_CHANNELS 전달 |
| 채널 구성 | 64 → 128 → 256 → 512 → 1024 (bottleneck) |
64 → 128 → 256 → 512 (bottleneck) |
| U-Net depth | 인코더 4단계 + bottleneck, pooling/upsampling 각 4회 | 인코더 3단계 + bottleneck, pooling/upsampling 각 3회 |
bottleneck feature map (128×128 입력) |
1024 × 8 × 8 |
512 × 16 × 16 |
| mask resize | NEAREST 보간 |
동일하게 NEAREST 보간 |
| mask 이진화 | Oxford Pet trimap에서 label == 1만 pet=1, 나머지는 0 |
동일 |
| mask 텐서 형태 | long 변환 → 이진 float → [1, H, W] |
long 변환 → 이진 float → [1, H, W] |
| mask augmentation | 없음 | 현재 설정상 학습 데이터에 수평 뒤집기 50% 적용 (USE_AUGMENTATION=True); 이미지와 mask를 함께 뒤집음 |
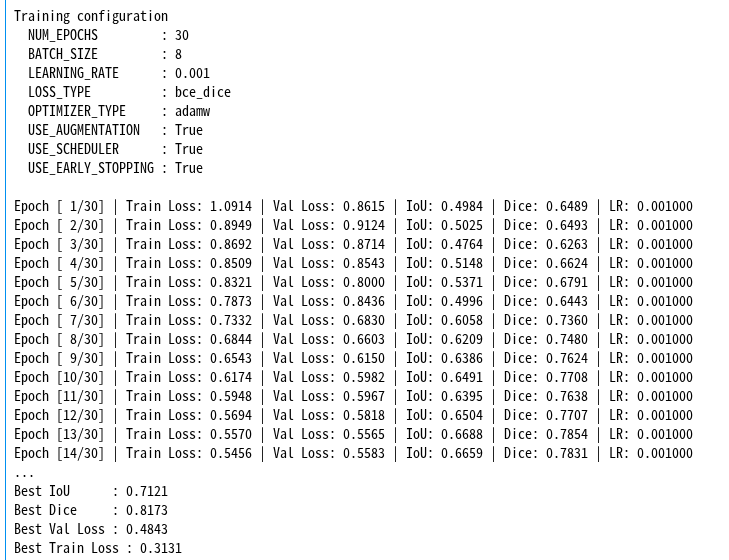
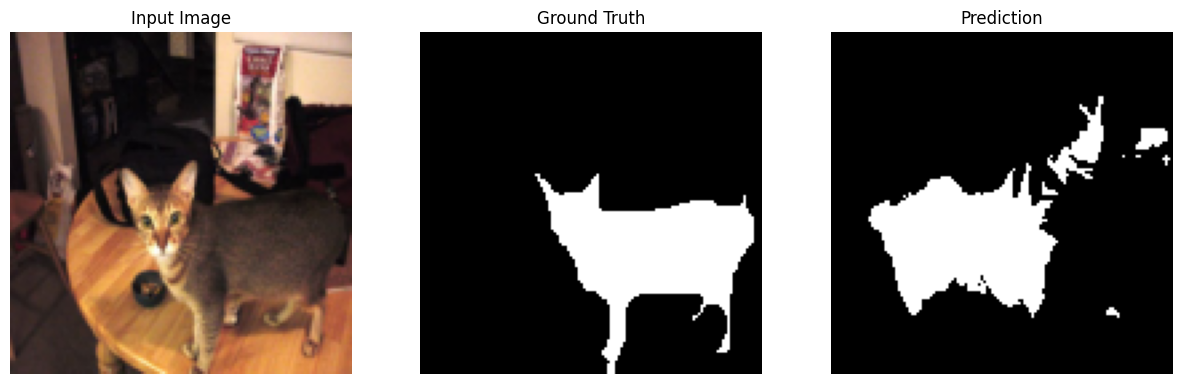
차이는 레이어 depth가 다르다.
이걸 바탕으로, 좀 더 성능을 올려보도록 해보자.
- Exp 6 : Depth 3 → 4
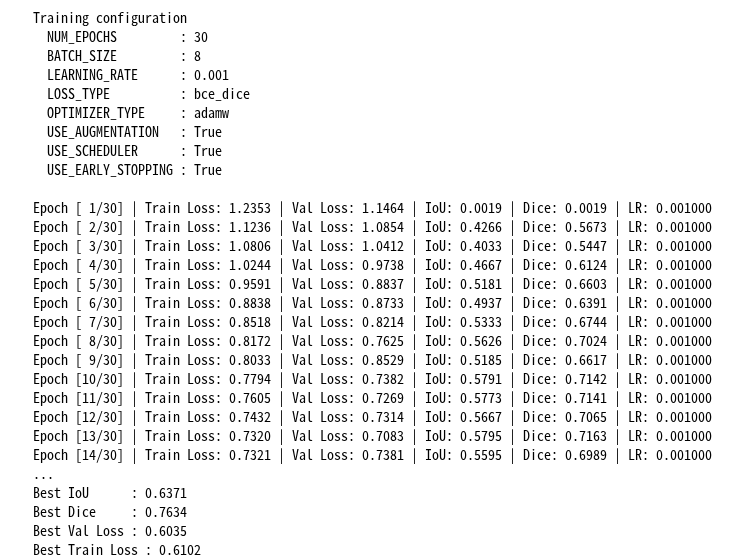
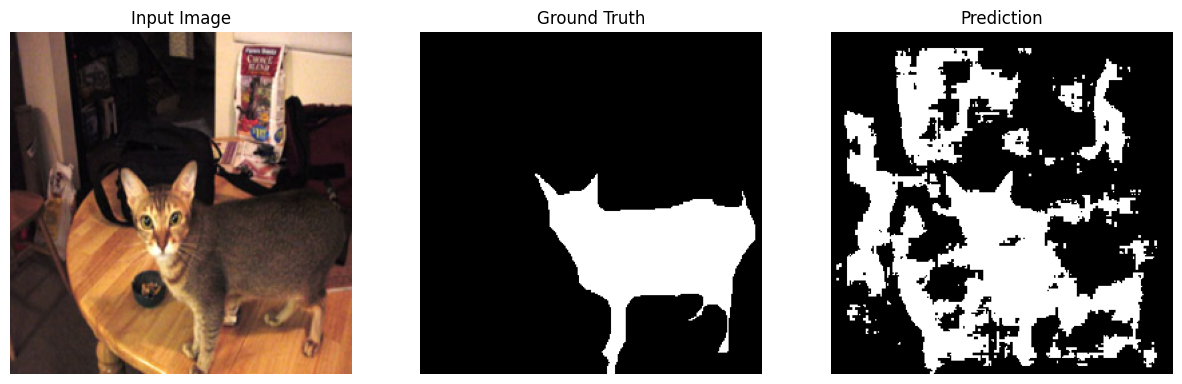
- Exp 7 : IMAGE_SIZE 128 → 256
- Exp 8 : BatchNorm 추가
- Exp 9 : Augmentation 강화
Exp 6. Depth 3 → 4
| 단계 | Loss | Aug. | Optimizer | Scheduler | Early Stop | IoU | Dice | Train Loss | Validation Loss |
|---|---|---|---|---|---|---|---|---|---|
| Exp 0 | BCE | X | Adam | X | X | 0.7020 | 0.8109 | 0.0933 | 0.3605 |
| Exp 1 | BCE+Dice | X | Adam | X | X | 0.7331 | 0.8325 | 0.1894 | 0.4952 |
| Exp 2 | BCE+Dice | O | Adam | X | X | 0.7506 | 0.8453 | 0.3065 | 0.4199 |
| Exp 3 | BCE+Dice | O | AdamW | X | X | 0.7516 | 0.8472 | 0.3140 | 0.4070 |
| Exp 4 | BCE+Dice | O | AdamW | O | X | 0.7651 | 0.8563 | 0.2611 | 0.3953 |
| Exp 5 | BCE+Dice | O | AdamW | O | O | 0.7520 | 0.8465 | 0.0.3012 | 0.4026 |
| Exp 6,Detph4 | BCE+Dice | O | AdamW | O | O | 0.7121 | 0.8173 | 0.3131 | 0.4843 |
Exp 7. Depth 4 + Image size 128 -> 256
Epoch가 부족하다. 30번보단 아마 50번정도 학습을 해야 할것 같다. 데이터의 사이즈가 증가하면 학습이 충분히 길어져야 할 것 같다.
| 단계 | Loss | Aug. | Optimizer | Scheduler | Early Stop | IoU | Dice | Train Loss | Validation Loss |
|---|---|---|---|---|---|---|---|---|---|
| Exp 0 | BCE | X | Adam | X | X | 0.7020 | 0.8109 | 0.0933 | 0.3605 |
| Exp 1 | BCE+Dice | X | Adam | X | X | 0.7331 | 0.8325 | 0.1894 | 0.4952 |
| Exp 2 | BCE+Dice | O | Adam | X | X | 0.7506 | 0.8453 | 0.3065 | 0.4199 |
| Exp 3 | BCE+Dice | O | AdamW | X | X | 0.7516 | 0.8472 | 0.3140 | 0.4070 |
| Exp 4 | BCE+Dice | O | AdamW | O | X | 0.7651 | 0.8563 | 0.2611 | 0.3953 |
| Exp 5 | BCE+Dice | O | AdamW | O | O | 0.7520 | 0.8465 | 0.0.3012 | 0.4026 |
| Exp 6,Detph4 | BCE+Dice | O | AdamW | O | O | 0.7121 | 0.8173 | 0.3131 | 0.4843 |
| Exp 7,Img Up | BCE+Dice | O | AdamW | O | O | 0.6371 | 0.7634 | 0.6102 | 0.6035 |
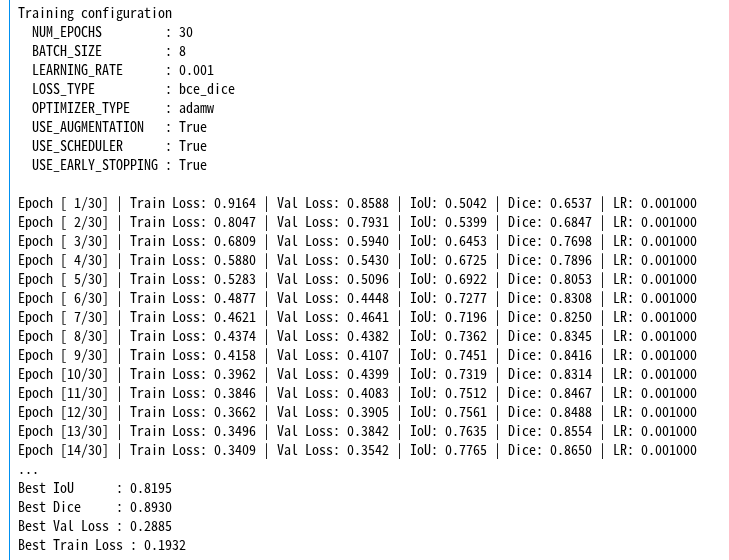
Exp 8. Depth 4, Image size 128, Batch Normailzation
DoubleConv 함수에 Conv2D 다음 ` nn.BatchNorm2d(out_channels),` 를 끼워 넣는다.
총 두번 끼워 넣으면 된다.
BatchNorm은 네트워크의 각 feature map을 다음 층이 다루기 쉬운 범위로 정리해주는 역할을 한다. BatchNorm을 넣으면 일반적으로 다음 효과를 기대할 수 있다.
- 학습 안정성 증가
- Gradient 흐름 개선
- 초기값 민감도 감소
- 수렴 속도 개선 가능
- 일부 regularization 효과
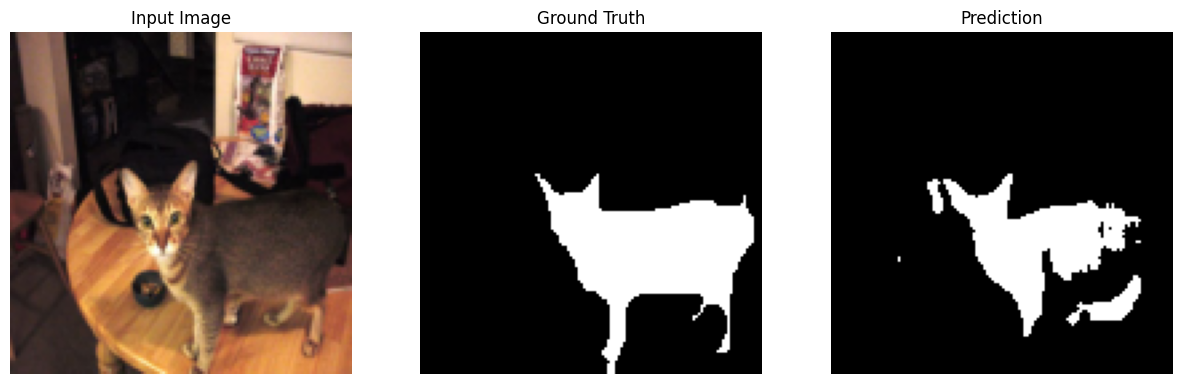
아.. .이놈이 크리티컬했구만.
Ep 30번을 돌려도 아직 좀 더 개선될 여지가 남아있다. 한 5%정도?
| 단계 | Loss | Aug. | Optimizer | Scheduler | Early Stop | IoU | Dice | Train Loss | Validation Loss |
|---|---|---|---|---|---|---|---|---|---|
| Exp 0 | BCE | X | Adam | X | X | 0.7020 | 0.8109 | 0.0933 | 0.3605 |
| Exp 1 | BCE+Dice | X | Adam | X | X | 0.7331 | 0.8325 | 0.1894 | 0.4952 |
| Exp 2 | BCE+Dice | O | Adam | X | X | 0.7506 | 0.8453 | 0.3065 | 0.4199 |
| Exp 3 | BCE+Dice | O | AdamW | X | X | 0.7516 | 0.8472 | 0.3140 | 0.4070 |
| Exp 4 | BCE+Dice | O | AdamW | O | X | 0.7651 | 0.8563 | 0.2611 | 0.3953 |
| Exp 5 | BCE+Dice | O | AdamW | O | O | 0.7520 | 0.8465 | 0.0.3012 | 0.4026 |
| Exp 6,Detph4 | BCE+Dice | O | AdamW | O | O | 0.7121 | 0.8173 | 0.3131 | 0.4843 |
| Exp 7,Img Up | BCE+Dice | O | AdamW | O | O | 0.6371 | 0.7634 | 0.6102 | 0.6035 |
| Exp 8,BatchNorm | BCE+Dice | O | AdamW | O | O | 0.8195 | 0.8930 | 0.1932 | 0.2885 |
Exp 9. Augmentation 심화
Day 2 실험에서는 augmentation에서 수평 flip만 시도했다.
여기에 변형 형태를 추가한다.
- Horizontal Flip
- Rotation
- Affine
- Color Jitter
다만, segmentation의 중요한 원칙, 변형은 image와 Mask 똑같이 적용해야 한다는걸 지켜야 한다. 이건 Day2에서도 이야기한 바 있다.
- Flip → image + mask
- Rotation → image + mask
-
Affine → image + mask
- Color → image만
- Brightness → image만
- Contrast → image만
이를 위해 class SegmentationTransform을 교체한다.
class SegmentationTransform:

    def __init__(
        self,
        image_size=256,
        augmentation=False
    ):

        self.image_size = image_size
        self.augmentation = augmentation


    def __call__(self, image, mask):

        # ====================================================
        # Resize
        # ====================================================

        image = TF.resize(
            image,
            [self.image_size, self.image_size],
            interpolation=TF.InterpolationMode.BILINEAR
        )

        mask = TF.resize(
            mask,
            [self.image_size, self.image_size],
            interpolation=TF.InterpolationMode.NEAREST
        )


        # ====================================================
        # Advanced Augmentation
        # ====================================================

        if self.augmentation:


            # ------------------------------------------------
            # 1. Horizontal Flip
            # image + mask
            # ------------------------------------------------

            if random.random() < 0.5:

                image = TF.hflip(image)
                mask = TF.hflip(mask)


            # ------------------------------------------------
            # 2. Random Rotation
            # image + mask
            # ------------------------------------------------

            if random.random() < 0.5:

                angle = random.uniform(
                    -10,
                    10
                )

                image = TF.rotate(
                    image,
                    angle,
                    interpolation=TF.InterpolationMode.BILINEAR
                )

                mask = TF.rotate(
                    mask,
                    angle,
                    interpolation=TF.InterpolationMode.NEAREST
                )


            # ------------------------------------------------
            # 3. Random Affine
            # image + mask
            # ------------------------------------------------

            if random.random() < 0.5:

                angle = random.uniform(-5, 5)

                translate = [
                    random.randint(
                        -int(self.image_size * 0.05),
                         int(self.image_size * 0.05)
                    ),
                    random.randint(
                        -int(self.image_size * 0.05),
                         int(self.image_size * 0.05)
                    )
                ]

                scale = random.uniform(
                    0.9,
                    1.1
                )


                image = TF.affine(
                    image,
                    angle=angle,
                    translate=translate,
                    scale=scale,
                    shear=[0.0, 0.0],
                    interpolation=TF.InterpolationMode.BILINEAR
                )

                mask = TF.affine(
                    mask,
                    angle=angle,
                    translate=translate,
                    scale=scale,
                    shear=[0.0, 0.0],
                    interpolation=TF.InterpolationMode.NEAREST
                )


            # ------------------------------------------------
            # 4. Color Augmentation
            # image only
            # ------------------------------------------------

            if random.random() < 0.5:

                brightness = random.uniform(
                    0.8,
                    1.2
                )

                contrast = random.uniform(
                    0.8,
                    1.2
                )

                saturation = random.uniform(
                    0.9,
                    1.1
                )


                image = TF.adjust_brightness(
                    image,
                    brightness
                )

                image = TF.adjust_contrast(
                    image,
                    contrast
                )

                image = TF.adjust_saturation(
                    image,
                    saturation
                )


        # ====================================================
        # Image -> Tensor
        # ====================================================

        image = TF.to_tensor(image)


        # ====================================================
        # Mask -> Binary Tensor
        # ====================================================

        mask = torch.as_tensor(
            np.array(mask),
            dtype=torch.long
        )

        mask = (mask == 1).float()

        mask = mask.unsqueeze(0)


        return image, mask
Augmentation을 강하게 하면 Train Loss가 올라가는 것이 정상일 수 있다. 모델 입장에서 매번 더 어려운 이미지를 받기 때문이다. 대신 IoU가 유지되고 있는데, 만약 IoU마저 떨어진다면 augmentation이 너무 강한 것일 수도 있다. 그땐 하나씩 줄여가면 된다. Color Jitter를 뺀다던가 하는 식이다.
| 단계 | Loss | Aug. | Optimizer | Scheduler | Early Stop | IoU | Dice | Train Loss | Validation Loss |
|---|---|---|---|---|---|---|---|---|---|
| Exp 0 | BCE | X | Adam | X | X | 0.7020 | 0.8109 | 0.0933 | 0.3605 |
| Exp 1 | BCE+Dice | X | Adam | X | X | 0.7331 | 0.8325 | 0.1894 | 0.4952 |
| Exp 2 | BCE+Dice | O | Adam | X | X | 0.7506 | 0.8453 | 0.3065 | 0.4199 |
| Exp 3 | BCE+Dice | O | AdamW | X | X | 0.7516 | 0.8472 | 0.3140 | 0.4070 |
| Exp 4 | BCE+Dice | O | AdamW | O | X | 0.7651 | 0.8563 | 0.2611 | 0.3953 |
| Exp 5 | BCE+Dice | O | AdamW | O | O | 0.7520 | 0.8465 | 0.0.3012 | 0.4026 |
| Exp 6,Detph4 | BCE+Dice | O | AdamW | O | O | 0.7121 | 0.8173 | 0.3131 | 0.4843 |
| Exp 7,Img Up | BCE+Dice | O | AdamW | O | O | 0.6371 | 0.7634 | 0.6102 | 0.6035 |
| Exp 8,BatchNorm | BCE+Dice | O | AdamW | O | O | 0.8195 | 0.8930 | 0.1932 | 0.2885 |
| Exp 9,Augm | BCE+Dice | O | AdamW | O | O | 0.8164 | 0.8913 | 0.2415 | 0.2868 |
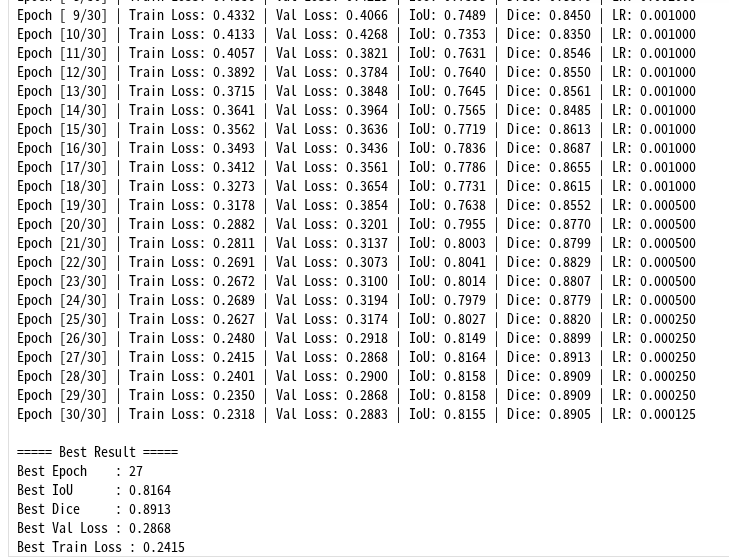
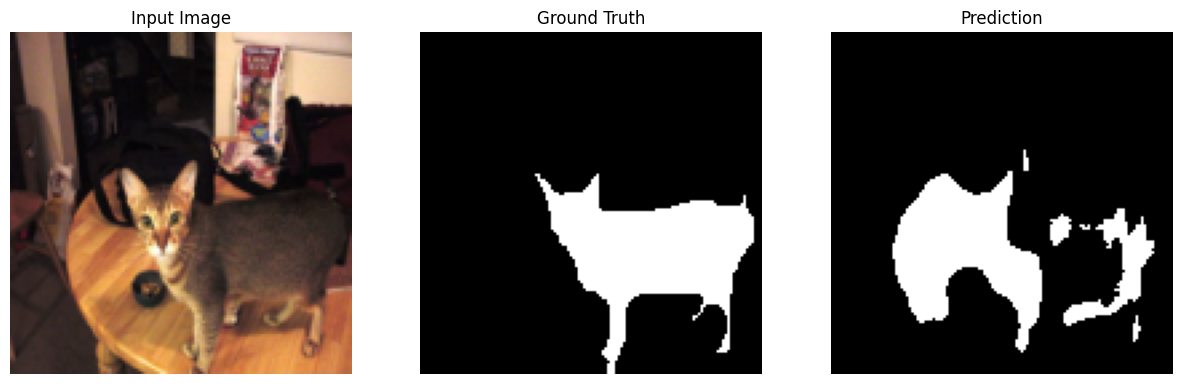
예상했던대로 Train loss의 하락이 좀 보인다. LR값을 보니 이것도 조금 더 학습할 수 있겠다 싶지만, 아무래도 Augmentation을 조금 줄여도 나쁘진 않을것 같단 생각은 든다.
결론
어디서 어떤 포인트를 수정할지 대충 감을 잡아보았다.
- BCE 단독보다는 BCE+Dice Loss가 좋았다. 특히 Dice/IoU값이 상승했다.
- Augmentation도 효과가 있었다. 간단해도 좋다.
- AdamW/Scheduler는 큰효과까지는 아니어도 약하게나마 도움은 된다.
- Early Stopping은 학습 횟수가 적으면 의미없다.
- 네트워크가 깊다고 나아지진 않는다.
- 이미지 사이즈도 크다고 좋은 건 아니다. 적절 사이즈가 있다.
- BatchNorm은 강력했다.
나중에 이거가지고 주효과 분석좀 해봐야겠다.
오늘은 여기까지.
댓글남기기